上一篇讲了为什么要分块,以及规则与条件被切散后可能出现什么问题。接下来,一个实际问题是:应该按长度切,按段落切,还是让模型判断哪里该切?
这些方法并没有统一的优劣排名。先看清它们依据什么决定边界,再结合文档与问题选择,会比记住一串名字更有用。
一、先分清两件事
切分边界回答“在哪里断开”。固定长度、递归切分、按标题切分和语义切分,主要讨论的是这个问题。
检索后取回的范围回答“命中一小段之后,还要带回多少上下文”。父子块通常还包含这种检索组织方式:用小块定位,再取回它所属的较大内容块。[4]
它们可以组合使用。例如先按标题形成父块,再用递归方法切出子块。因此,父子块不能简单理解成比递归切分更高级的另一把“切刀”。
二、从同一份手册看三种边界
继续使用虚构的《文档助手说明书》:
文件上传:支持 PDF、TXT 和 DOCX。扫描版 PDF 需先完成 OCR,再上传。
账户设置:用户可以修改昵称和头像。
这只是教学示例。为了看清边界,下面省略完整产品规则和具体长度参数。
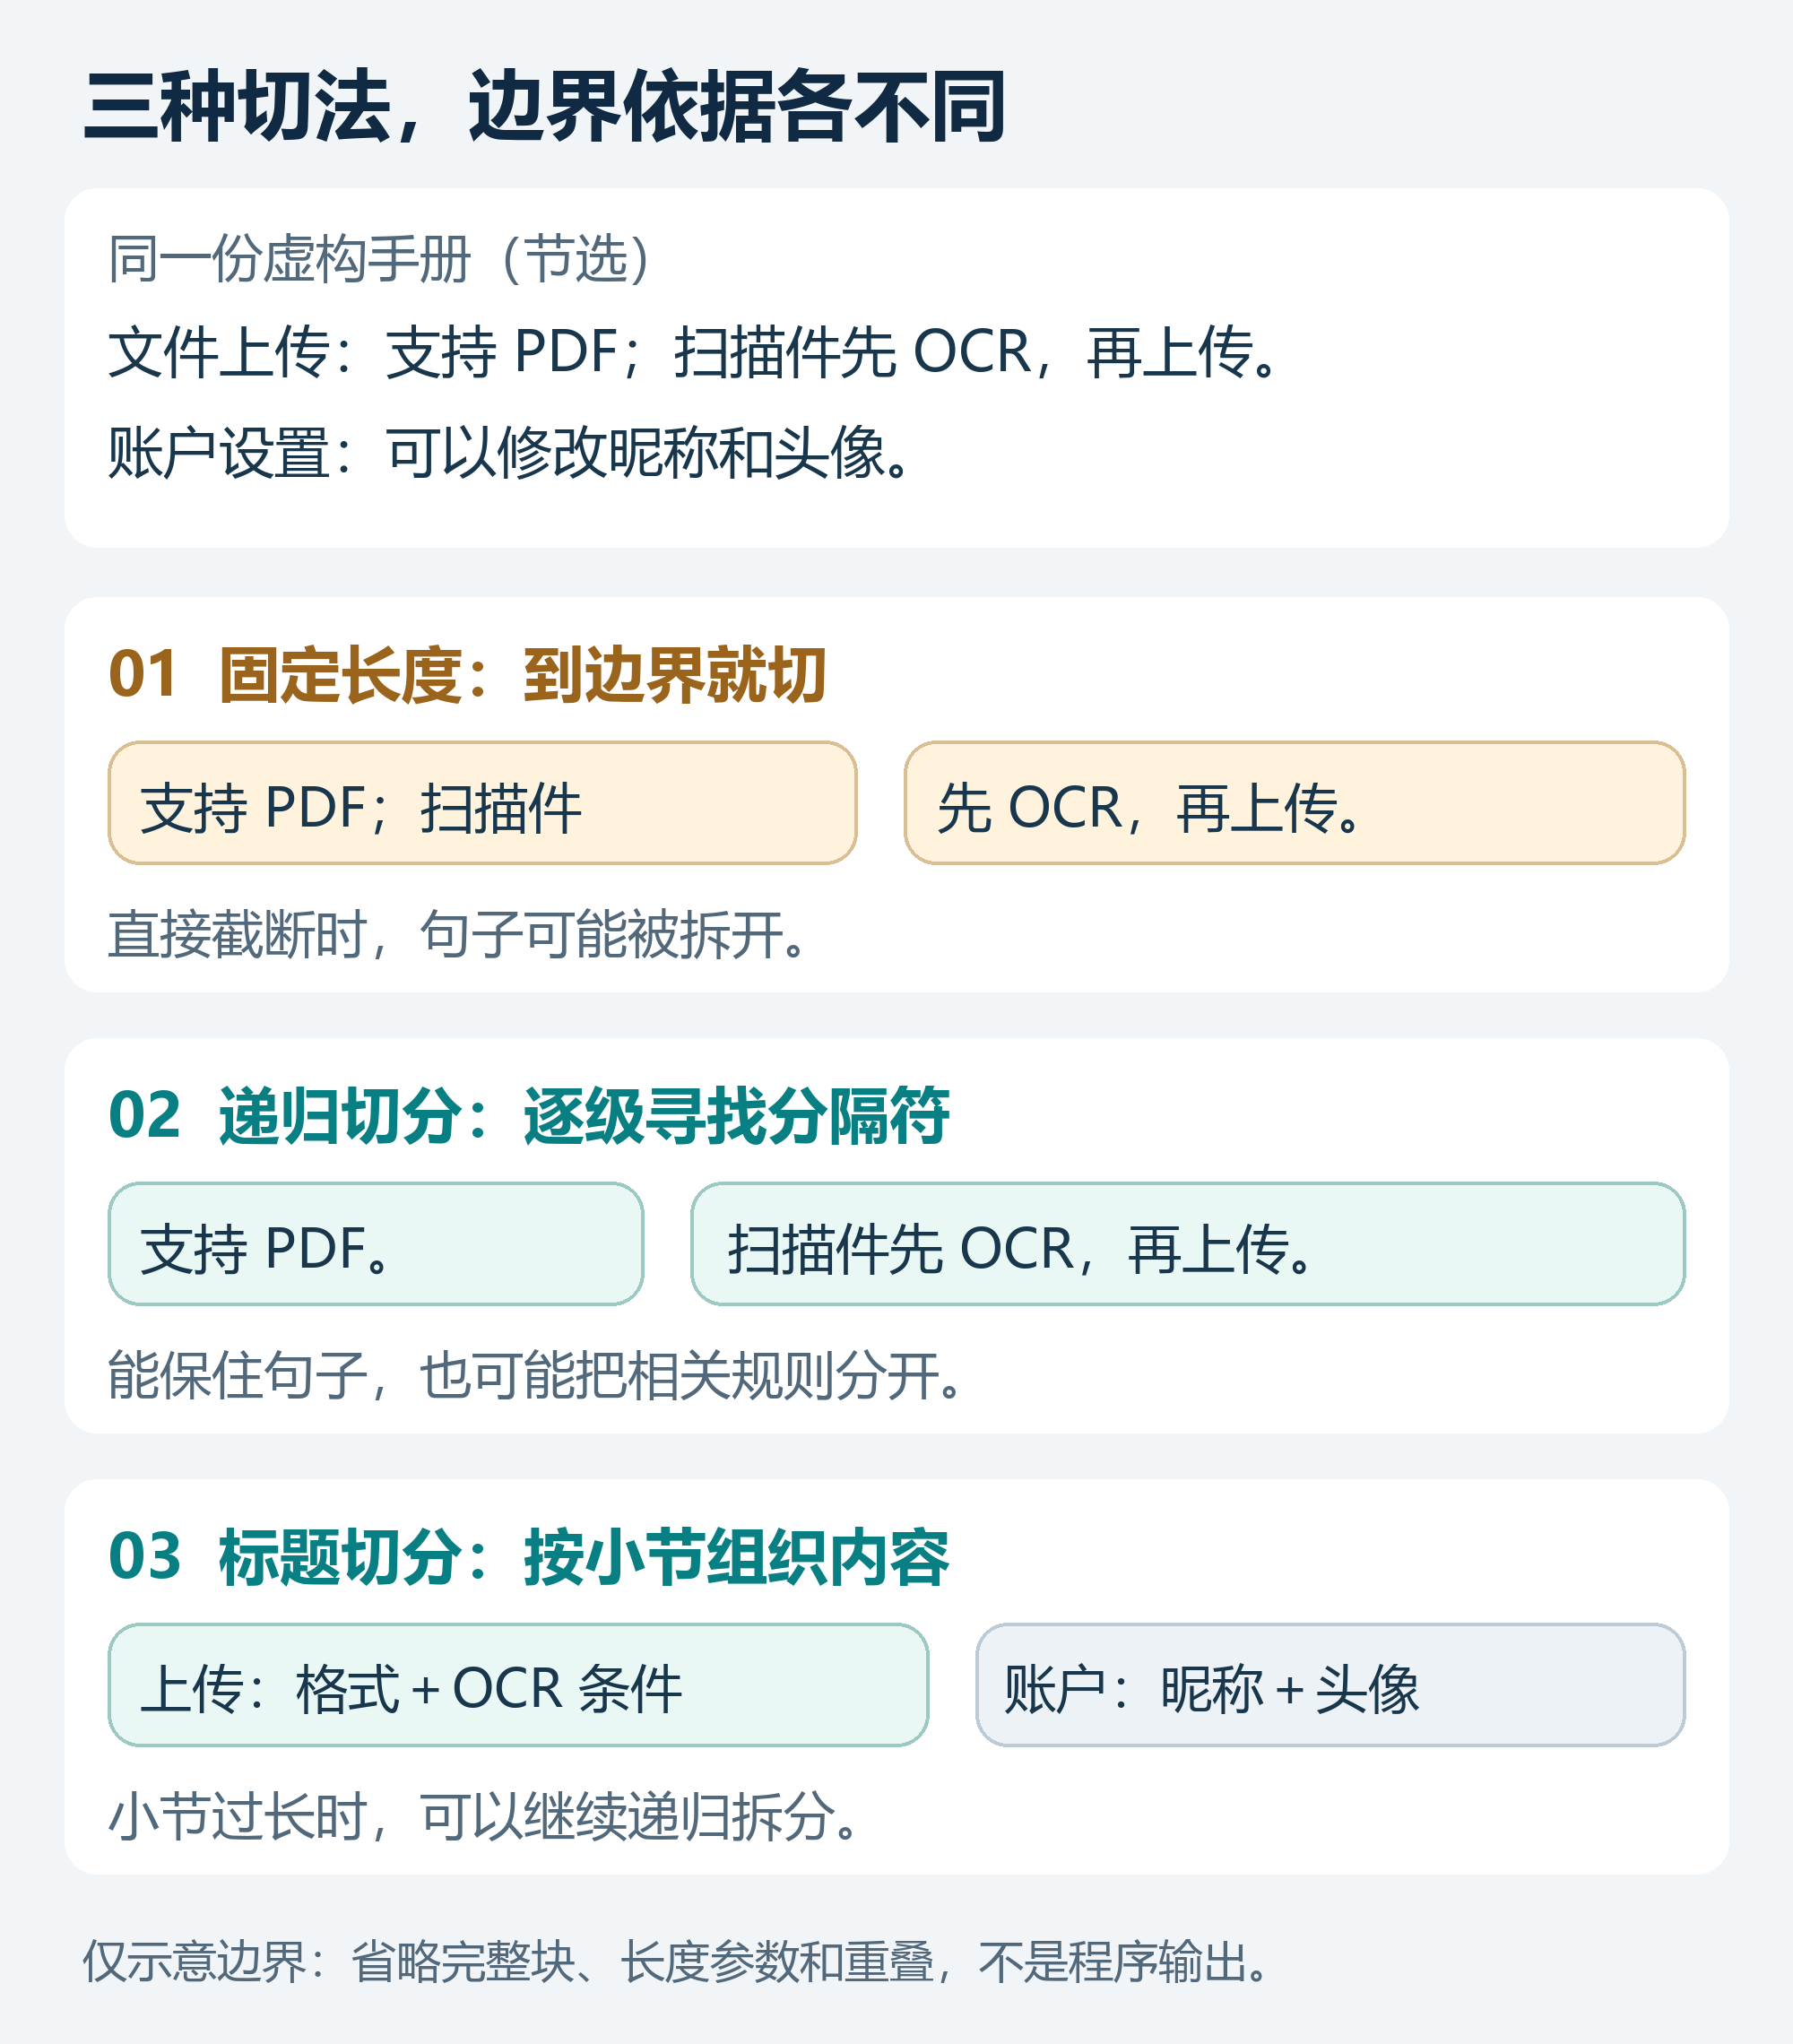
图 1:节选对比切分位置,不是某个库的实际运行结果,也没有展示所有块。
1. 固定长度:容易实现的起点
最直接的做法是按设定的字符数或 token 数切分,必要时设置重叠。长度单位取决于实现,字符数不能直接当成 token 数。
这种方法实现简单、便于控制长度,适合作为比较方案的起点。但如果直接在长度边界截断,句子和限制条件都可能被拆开。若实现会寻找附近的句末边界,具体结果又会有所不同。
2. 递归切分:优先使用文本边界
递归切分通常先尝试较粗的分隔符,片段仍过长时,再使用更细的分隔符。例如先按段落,必要时继续按句子或字符拆分。
这里的“递归”描述的是逐级细分的过程。常见的递归字符切分并不自动理解业务规则之间的依赖。 两句话即使各自完整,“支持 PDF”和“扫描件先 OCR”仍可能分属不同块。[1]
处理中文时,要检查分隔符是否包含中文标点,不能照搬只适合英文空格与换行的配置。
3. 按标题切分:利用已有的文档结构
手册已经划分“文件上传”和“账户设置”时,可以据此分组,让同一小节的规则尽量放在一起。
但一个小节也可能很长。实际可以先按标题分组,再对过长的小节递归切分。还应保留标题路径,帮助片段说明“自己来自哪里”;如果标题只存于元数据,就要确保后续检索或上下文组织确实使用了它。[2]
这类方法依赖结构提取质量。PDF 的标题若被识别成普通正文,切分器就未必能按预期工作。
三、没有清楚的标题,可以考虑语义切分吗?
可以把它作为候选方案。以 LlamaIndex 的一种实现为例:先组织句子及邻近文本,再通过嵌入相似度寻找可能的主题变化位置。[3]
它适合用来探索“排版结构不明显,但内容有话题变化”的材料。不过,这种相似度是模型表示上的接近程度,不等于规则之间的逻辑依赖。
例如“支持 PDF”和“扫描件必须先 OCR”都与上传有关,如何划为一组仍受嵌入模型和阈值影响。采用这种实现,还要考虑额外的嵌入计算、中文断句与长度上限,不能只看到“语义”二字就默认效果更好。
四、父子块:先定位小片段,再补回上下文
假设某个“文件上传”小节很长,既想用具体句子定位问题,又不想漏掉前后条件,可以保留两层内容:
- 父块:较完整的小节。
- 子块:从这个小节切出的较小片段,保存对应父块的标识。
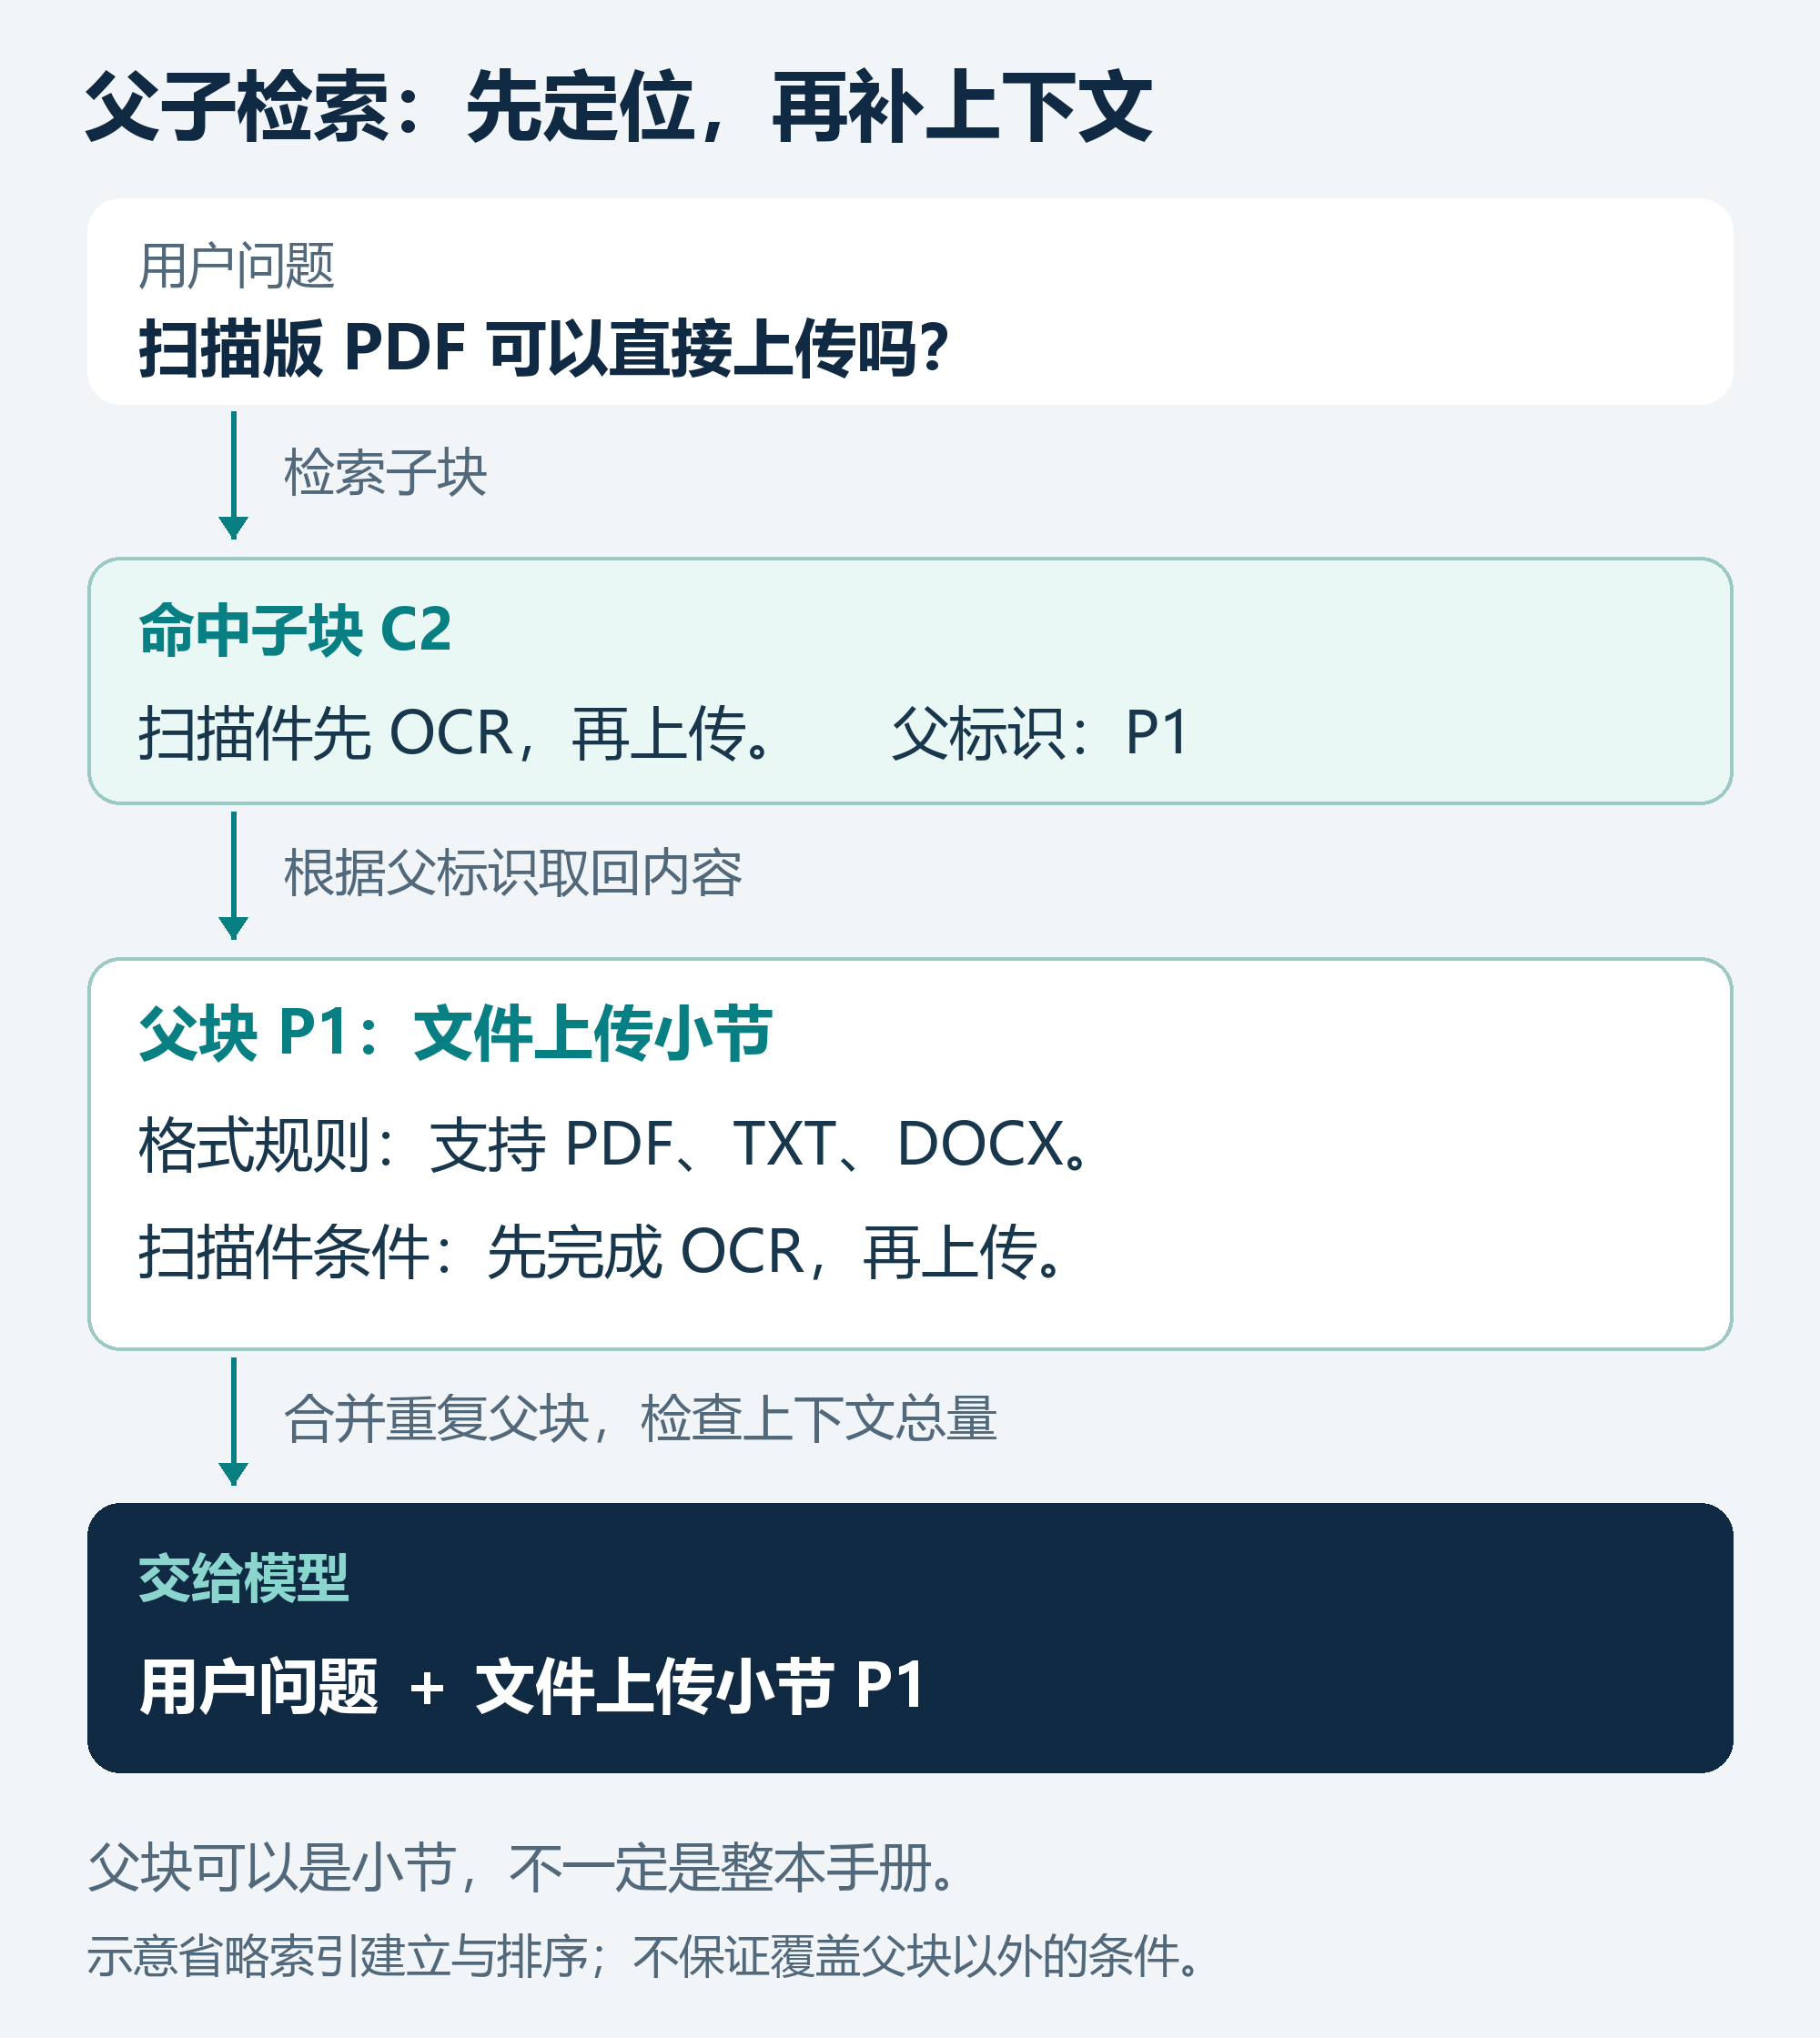
图 2:子块承担检索定位,父块补充上下文;同一个父块被多个子块命中时,需要合并重复结果。
当问题命中“扫描件先 OCR”的子块,系统再根据父标识取回“文件上传”父块,把其中的格式规定和处理条件一起组织进上下文。父块可以是较大的片段,不一定是整本手册。[4]
代价是需要维护两层内容及映射关系,而且取回大块后仍可能带入噪声、占用更多上下文。父子关系也不能补回不在该父块中的条件。
五、开始做项目时,怎样选择?
可以先根据资料形态选择一个容易检查的起点:
| 资料特点或遇到的问题 | 可以先尝试 |
|---|---|
| 很短且独立完整的 FAQ | 每条问答作为一个单元,不必继续拆细 |
| 小节清楚的手册、Markdown 文档 | 按标题分组,过长部分再递归拆分 |
| 标题不稳定的普通长文本 | 用递归切分建立基线,再检查实际边界 |
| 结构不清,话题变化明显 | 评估语义切分,比较计算成本与检索效果 |
| 小块能定位,但经常漏掉同小节条件 | 考虑父子检索,并限制取回的上下文总量 |
这是一份起步建议,不是性能排行榜。先固定一组真实问题、嵌入模型、召回设置和上下文预算,再比较不同方案:关键证据是否齐全、重复与无关内容有多少、时间和成本是否可接受。
特别留意包含“例外”“必须先”“仅限”等条件的问题。一个方案能回答普通问题,不代表它能保住这些限制。
六、面试时可以怎样回答?
常见分块方法有固定长度、递归、按文档结构和语义边界切分。它们分别依赖长度、分隔符层级、标题结构和语义变化。父子块还涉及检索组织:先检索小块,再取回对应的大块补充上下文。实际可以组合使用,结合资料形态、模型限制和真实问题评估,不能仅按方法名称判断效果。
选择分块策略时,先问两个问题:这份资料有什么可靠的结构?用户需要哪些证据才能得到完整回答?方法应围绕这两个问题来选。
参考资料
- LangChain:Splitting recursively——递归分隔符、长度单位及中文处理。
- LangChain:Split markdown——标题分组、元数据与后续长度约束。
- LlamaIndex:Semantic Chunker——一种基于句子嵌入相似度的语义切分实现。
- LangChain:ParentDocumentRetriever——先检索子块,再取回父文档或较大父块。
- 题库第 17 题:在 RAG 中,常见的分块策略有哪些?分别有什么区别?——选题来源。
评论交流
欢迎留下你的想法