检索找到了相关材料,回答却仍然抓不住重点。问题有时出在排序:真正能回答问题的片段已经进入候选列表,却排在后面,没有被选进模型上下文。
上一篇介绍了关键词与向量的混合检索。这次继续往后看:候选找到以后,Rerank(重排序,也常称精排)怎样决定哪些片段更值得优先使用?
一、精排处理的是哪一步?
一种常见流程是:先用关键词、向量或混合检索获得候选,再对候选做更细的相关性判断,最后选择一部分内容交给生成模型。[1]
召回阶段需要在较大的资料集合中快速寻找可能相关的内容;精排面对的范围更小,可以投入更多计算。
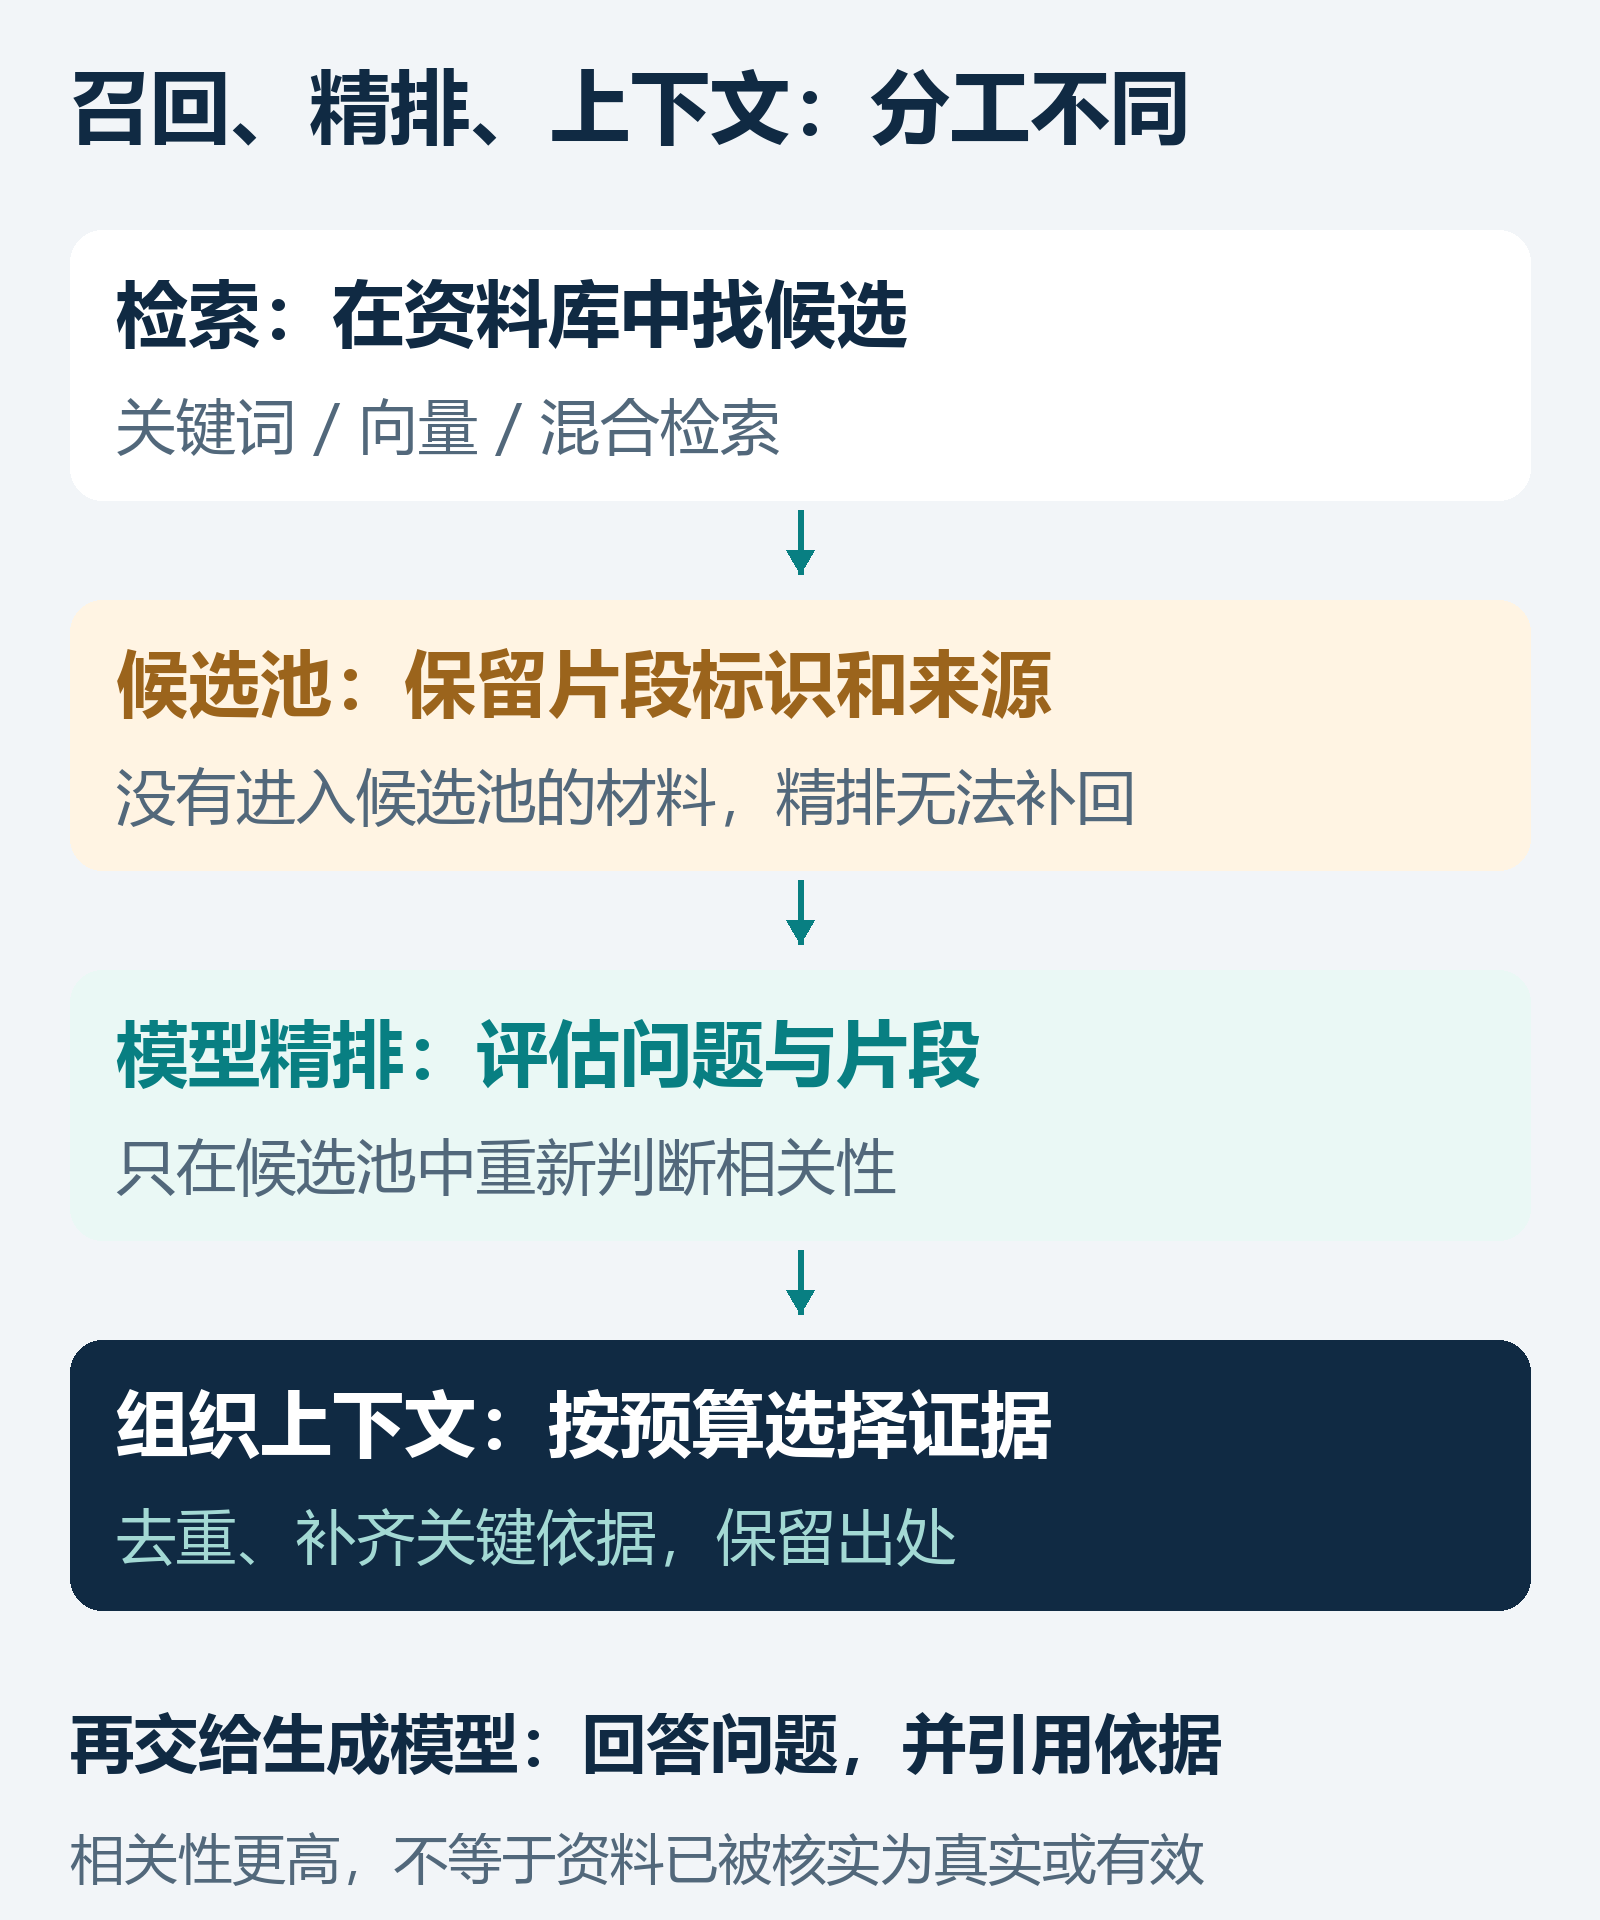
图 1:精排发生在已有候选之上。它改变候选的顺序,不会自动扩大检索范围。
这里有个容易忽略的前提:正确材料得先进入精排的候选池。 如果原文没有被解析出来、查询过滤错了,或者第一阶段完全没召回它,再好的精排器也无法凭空补回。
二、Cross-Encoder 为什么要一起看问题和片段?
常见向量检索使用双编码器(Bi-Encoder)思路:问题与文档分别编码,再比较向量。文档向量可以提前计算并建立索引,适合大范围检索。[2]
常见的模型精排方案则使用交叉编码器(Cross-Encoder):把问题和一个候选片段作为一对输入,让模型在联合处理时判断二者的关系,输出相关性分数。[2][3]
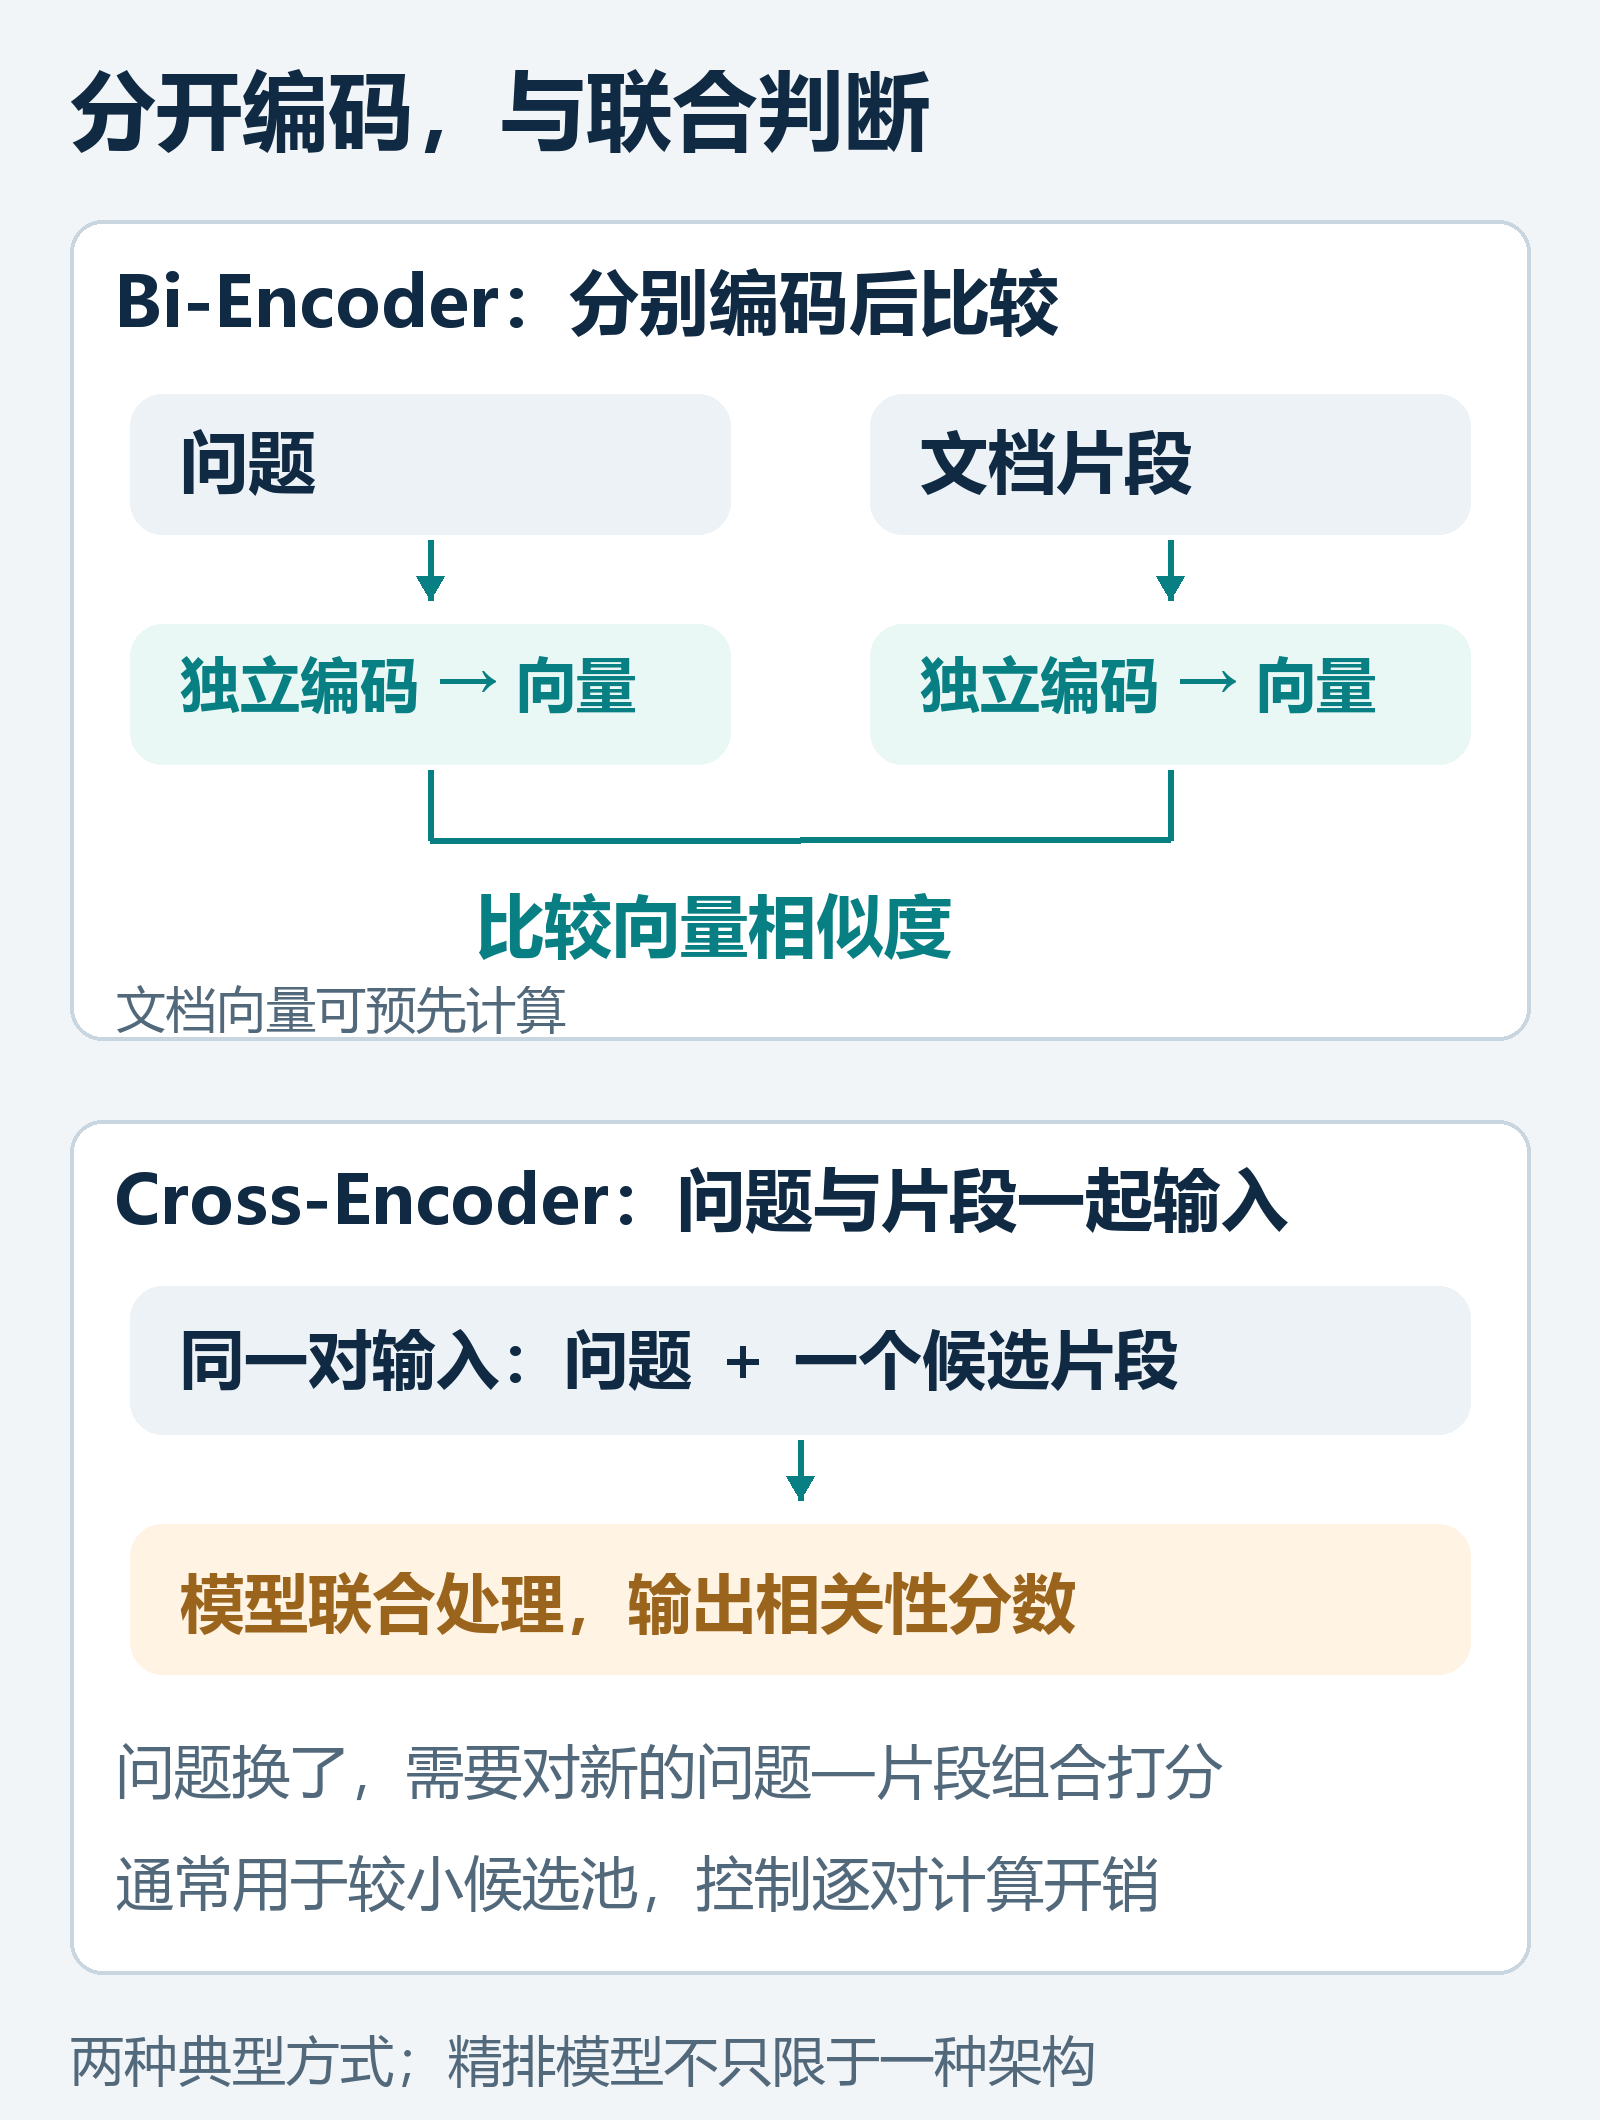
图 2:比较的是两种典型匹配方式;Rerank 是流程角色,并不只限于一种模型架构。
例如,查询要了解“RRF 与模型精排的区别”,只介绍 RRF 公式的段落和直接比较两者职责的段落,都可能谈到相同术语。精排希望进一步判断:哪一段更贴近问题要求的比较关系,而不只是主题接近。
联合处理并不意味着一定排对。中文能力、领域术语、训练任务与输入格式,都可能影响结果。BERT 用于段落重排序已有研究,但论文中的数据集成绩不能直接当作自己知识库的收益。[4]
三、RRF 和模型精排有什么区别?
RRF 根据片段在各路结果中的名次汇总贡献,得到统一排序;它本身不读取问题与片段的正文,重新做语义判断。
模型精排则重新评估“问题—片段”的匹配程度。两者可以串联,也可以只在单路检索后使用精排:精排并不以混合检索为前提,也不是每个 RAG 系统都必须增加的一步。[1]
把更多组件接起来,只能说明流程更复杂,不能证明回答更准确。需要验证当前问题究竟是“没找着”,还是“找着了但排得不好”。
四、候选数量和最终上下文,要分开控制
可以分别记下两个数量:
- 送入精排的候选数:决定要重新打分多少个片段。
- 最终保留的片段数:决定哪些材料可能进入生成上下文。
前者增大,可能带来更多可选证据,也会增加推理工作;后者增大,则要考虑上下文长度、重复材料和无关内容。两者没有一组适用于所有知识库的固定最优值。
相关性分数也不要直接解释成“答案正确率”。模型可能输出原始分数,也可能经过激活函数转换;具体含义取决于模型和配置。[3] 即使显示在 0 到 1 之间,也不能据此断言“0.8 就有八成把握答对”。分数阈值需要结合实际问题集验证。
五、排第一之后,还要检查什么?
先检查送进去的文本。 片段太长时,问题和文档的联合输入可能超出模型窗口,关键条件会被截断。不能只看原文完整,就认为精排器也读到了全部内容。[5]
再检查证据是否互补。 多个高分片段可能只是重复表达同一件事。若问题需要比较两个概念,最终上下文还要覆盖两边的依据,不能只保留单项相关性高、内容却高度重复的片段。
最后检查来源与适用范围。 权限过滤、资料版本和出处需要在流程中明确维护。精排分数衡量的是某种相关性,不负责证明资料真实、当前有效或允许访问。
六、怎样判断值得增加精排?
先固定第一阶段的候选列表,用同一组问题比较精排前后的结果,避免把召回变化误认为精排收益。
排序质量可以观察首个相关片段的位置;有标注数据时,MRR 关注首个相关结果的排名,nDCG 则兼顾相关程度与排序位置。[6] 对需要多份材料的问题,还要逐项核对关键依据是否齐全。
然后再看最终回答:是否回答了问题、引用是否支持结论、是否漏掉条件。排序改善不等于生成质量必然同步改善。
最后分别记录延迟与成本:候选数、文本长度、批量大小、硬件和模型都会影响实际开销。只有质量收益与响应时间、资源消耗都符合需求,新增精排才值得保留。
七、面试时可以怎样回答?
Rerank 对第一阶段召回的候选重新排序,常用 Cross-Encoder 联合处理问题与片段,输出相关性分数,再按上下文预算选择证据。它与基于名次的 RRF 融合职责不同,也不能找回未进入候选池的内容。实践中要检查输入截断、重复证据与模型适配,用相同候选比较排序和回答质量,同时测量延迟与成本。
精排解决的是“已有候选怎样排得更好”。下一步还要考虑:排好的片段,怎样组织成一份完整、精简而且可追溯的上下文。
参考资料
- Sentence Transformers:Retrieve & Re-Rank——两阶段检索与精排。
- Sentence Transformers:Cross-Encoder vs. Bi-Encoder——独立编码与联合输入的区别。
- Sentence Transformers:CrossEncoder——联合处理、分数与输出配置。
- Nogueira & Cho:Passage Re-ranking with BERT——段落重排序研究。
- Elastic:Semantic reranking——候选范围、计算开销与长文档截断。
- 李博杰,《深入理解 AI Agent:设计原理与工程实践》,v1.2(2026-07-22),第 3 章 §3.2.4,书内 86–87 页(PDF 94–95 页)——重排序及检索质量指标;本文未复用书中图表或实验数值。
- 题库第 3 题:什么是 RAG 中的 Rerank?具体需要怎么做?、第 307 题:RAG 为什么需要重排序 Reranking?如何实现?——选题参考。
评论交流
欢迎留下你的想法