找到了相关材料,也把它们排好了,回答就一定有依据吗?还差一步:模型实际收到的上下文,可能重复、缺少条件,或者已经被长度限制截断。
上一篇讲了精排。这次继续往后看,怎样把候选片段整理成一份便于使用、能够回查的证据材料。
一、不是把前几条结果直接拼起来
检索和精排决定“哪些片段可能相关”;上下文组织还要决定“这次回答实际需要哪些内容”。
问题、任务指令、必要的历史消息、工具信息和检索材料,都可能进入同一次模型请求。[1] 因此,证据不是一个可以无限填充的文本框。
例如,要回答“RRF 与模型精排有什么区别”,只塞入几段反复讲 RRF 的文字,即使每一段都相关,也可能缺少模型精排的依据。单个片段相关,不代表合在一起就覆盖了整个问题。
二、先保留完整意思,再去掉重复
可以先按片段标识去除同一块的重复返回,再检查相邻片段是否存在大段重叠。来自不同来源、表达接近的材料,则要保留来源差异,不能仅因措辞相似就认定它们完全等价。
真正要保护的是回答所需的事实、限制条件和解释关系。合并相邻片段时,应核对文档与版本,不能跨文档盲目拼接,也不能为了短一点,先把否定词、适用条件或表格说明删掉。
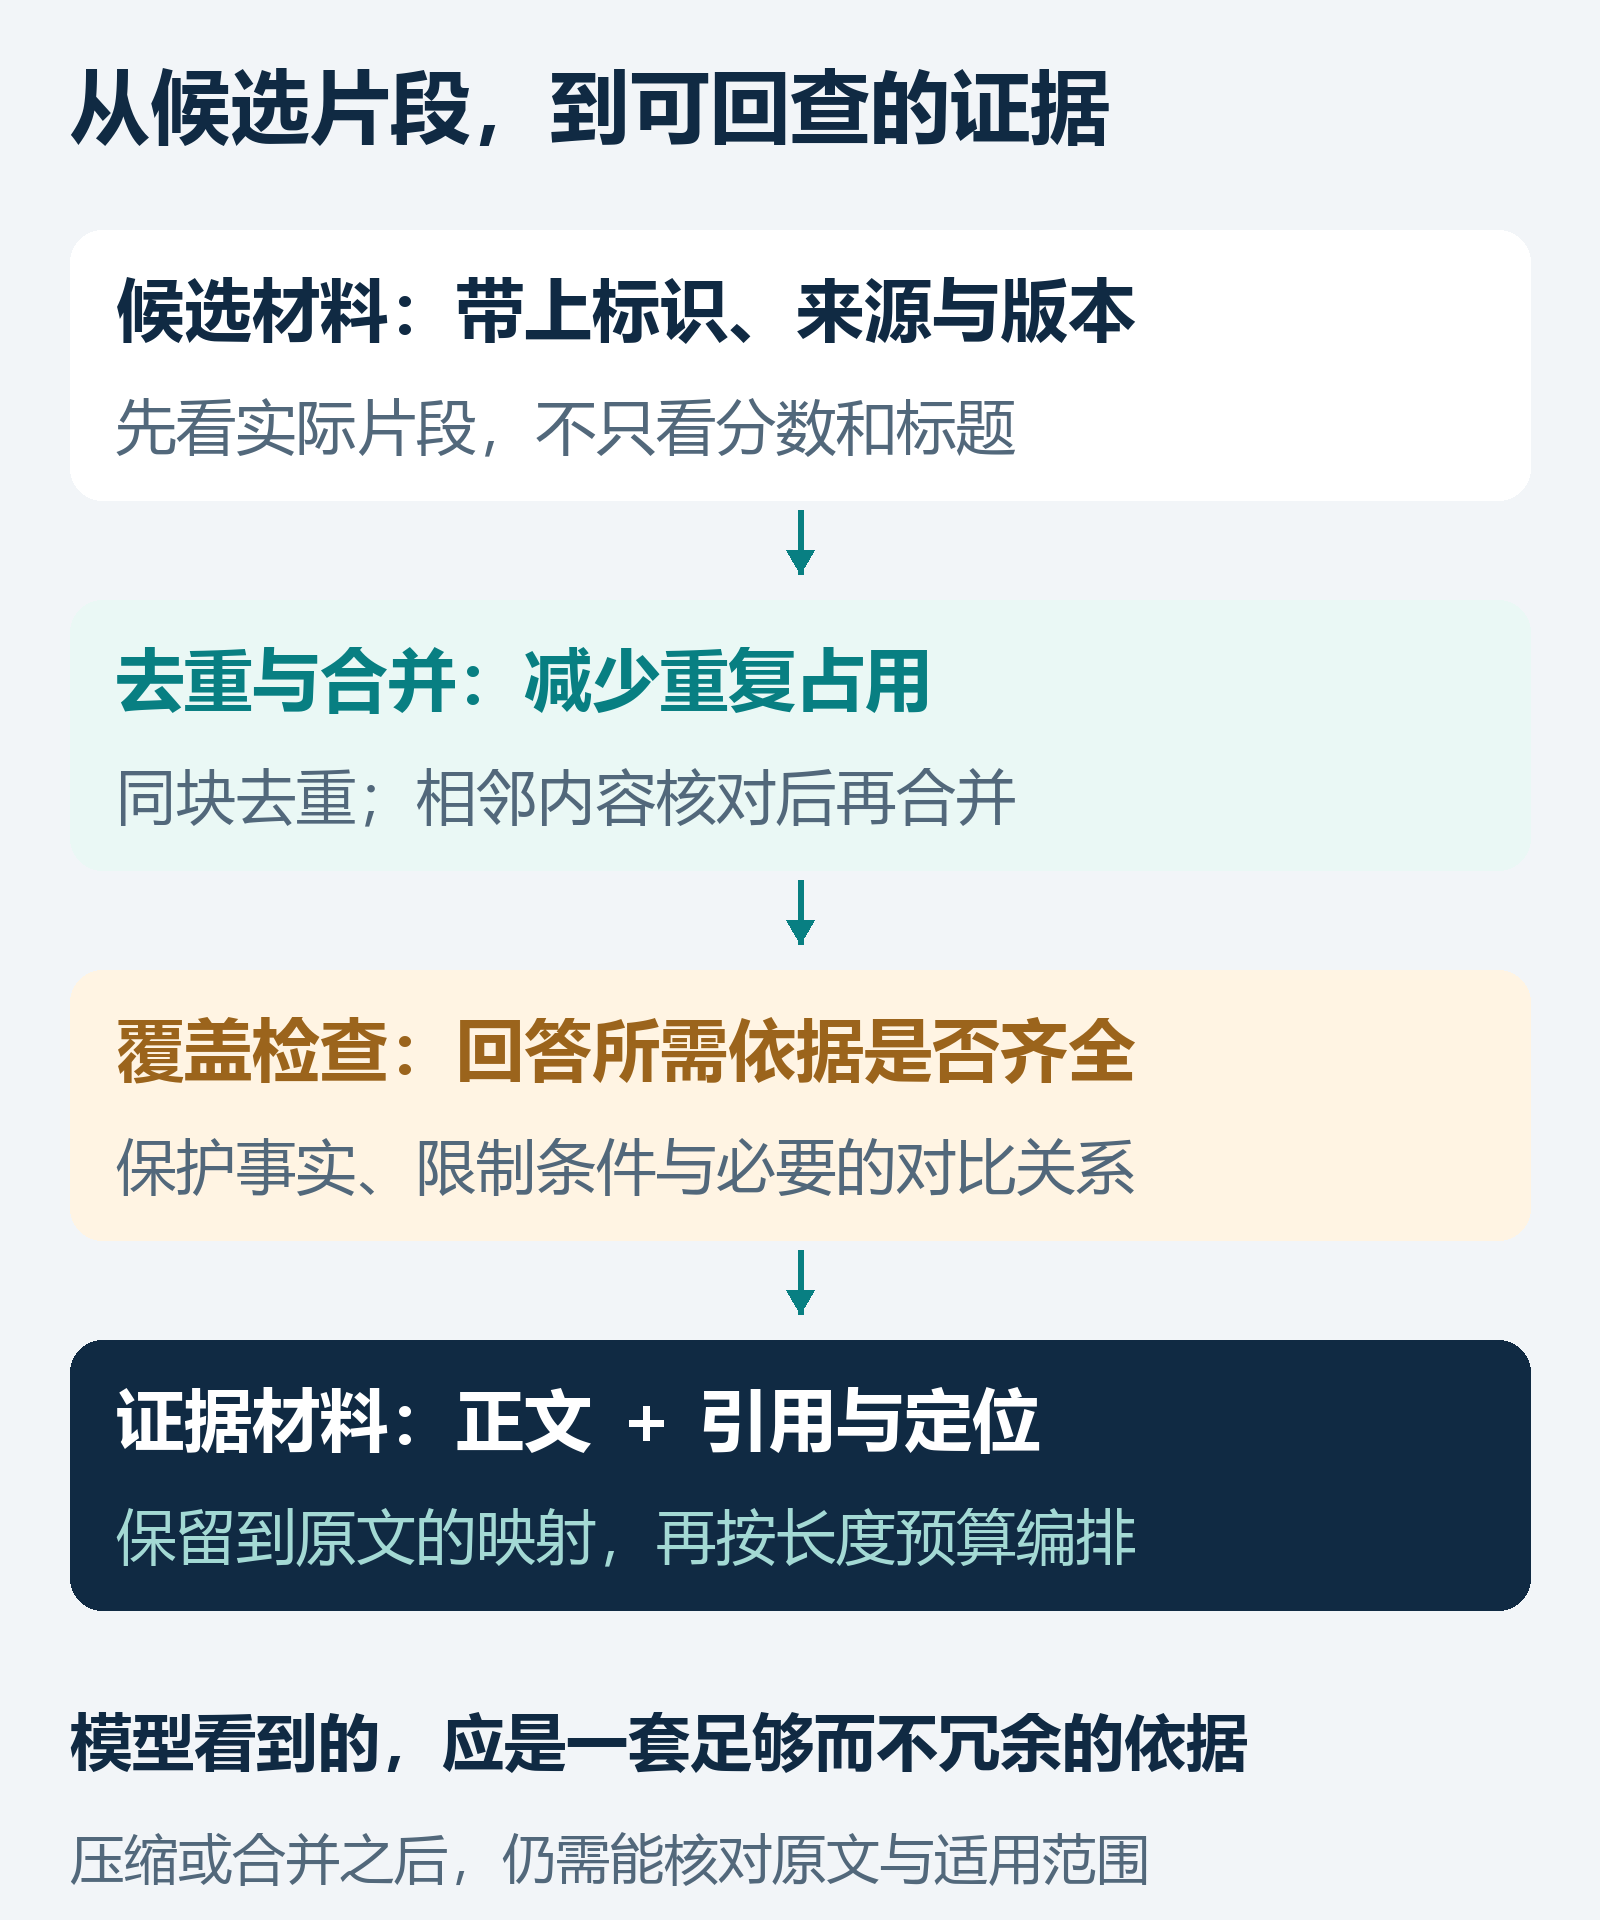
图 1:筛选的目标是减少冗余,同时保住关键依据;不是单纯追求片段数量最少。
如果使用模型压缩材料,要回查压缩结果是否改变原意。压缩后的句子也应能追溯到原始片段,而不是只保留一份无法核对的摘要。
三、先算预算,再决定放多少材料
不要把“上下文窗口很大”理解成“都能留给文档”。先核对具体模型和接口:限制的是总窗口,还是分别规定输入、输出上限;若输入输出共享窗口,还需要给回答预留空间。
在输入侧,先计入任务指令、当前问题、必要历史和工具定义等内容,再确定检索材料可以使用的预算。Token 也不等于汉字数量,应按所用模型的计数方式估算或检查实际请求。[2]
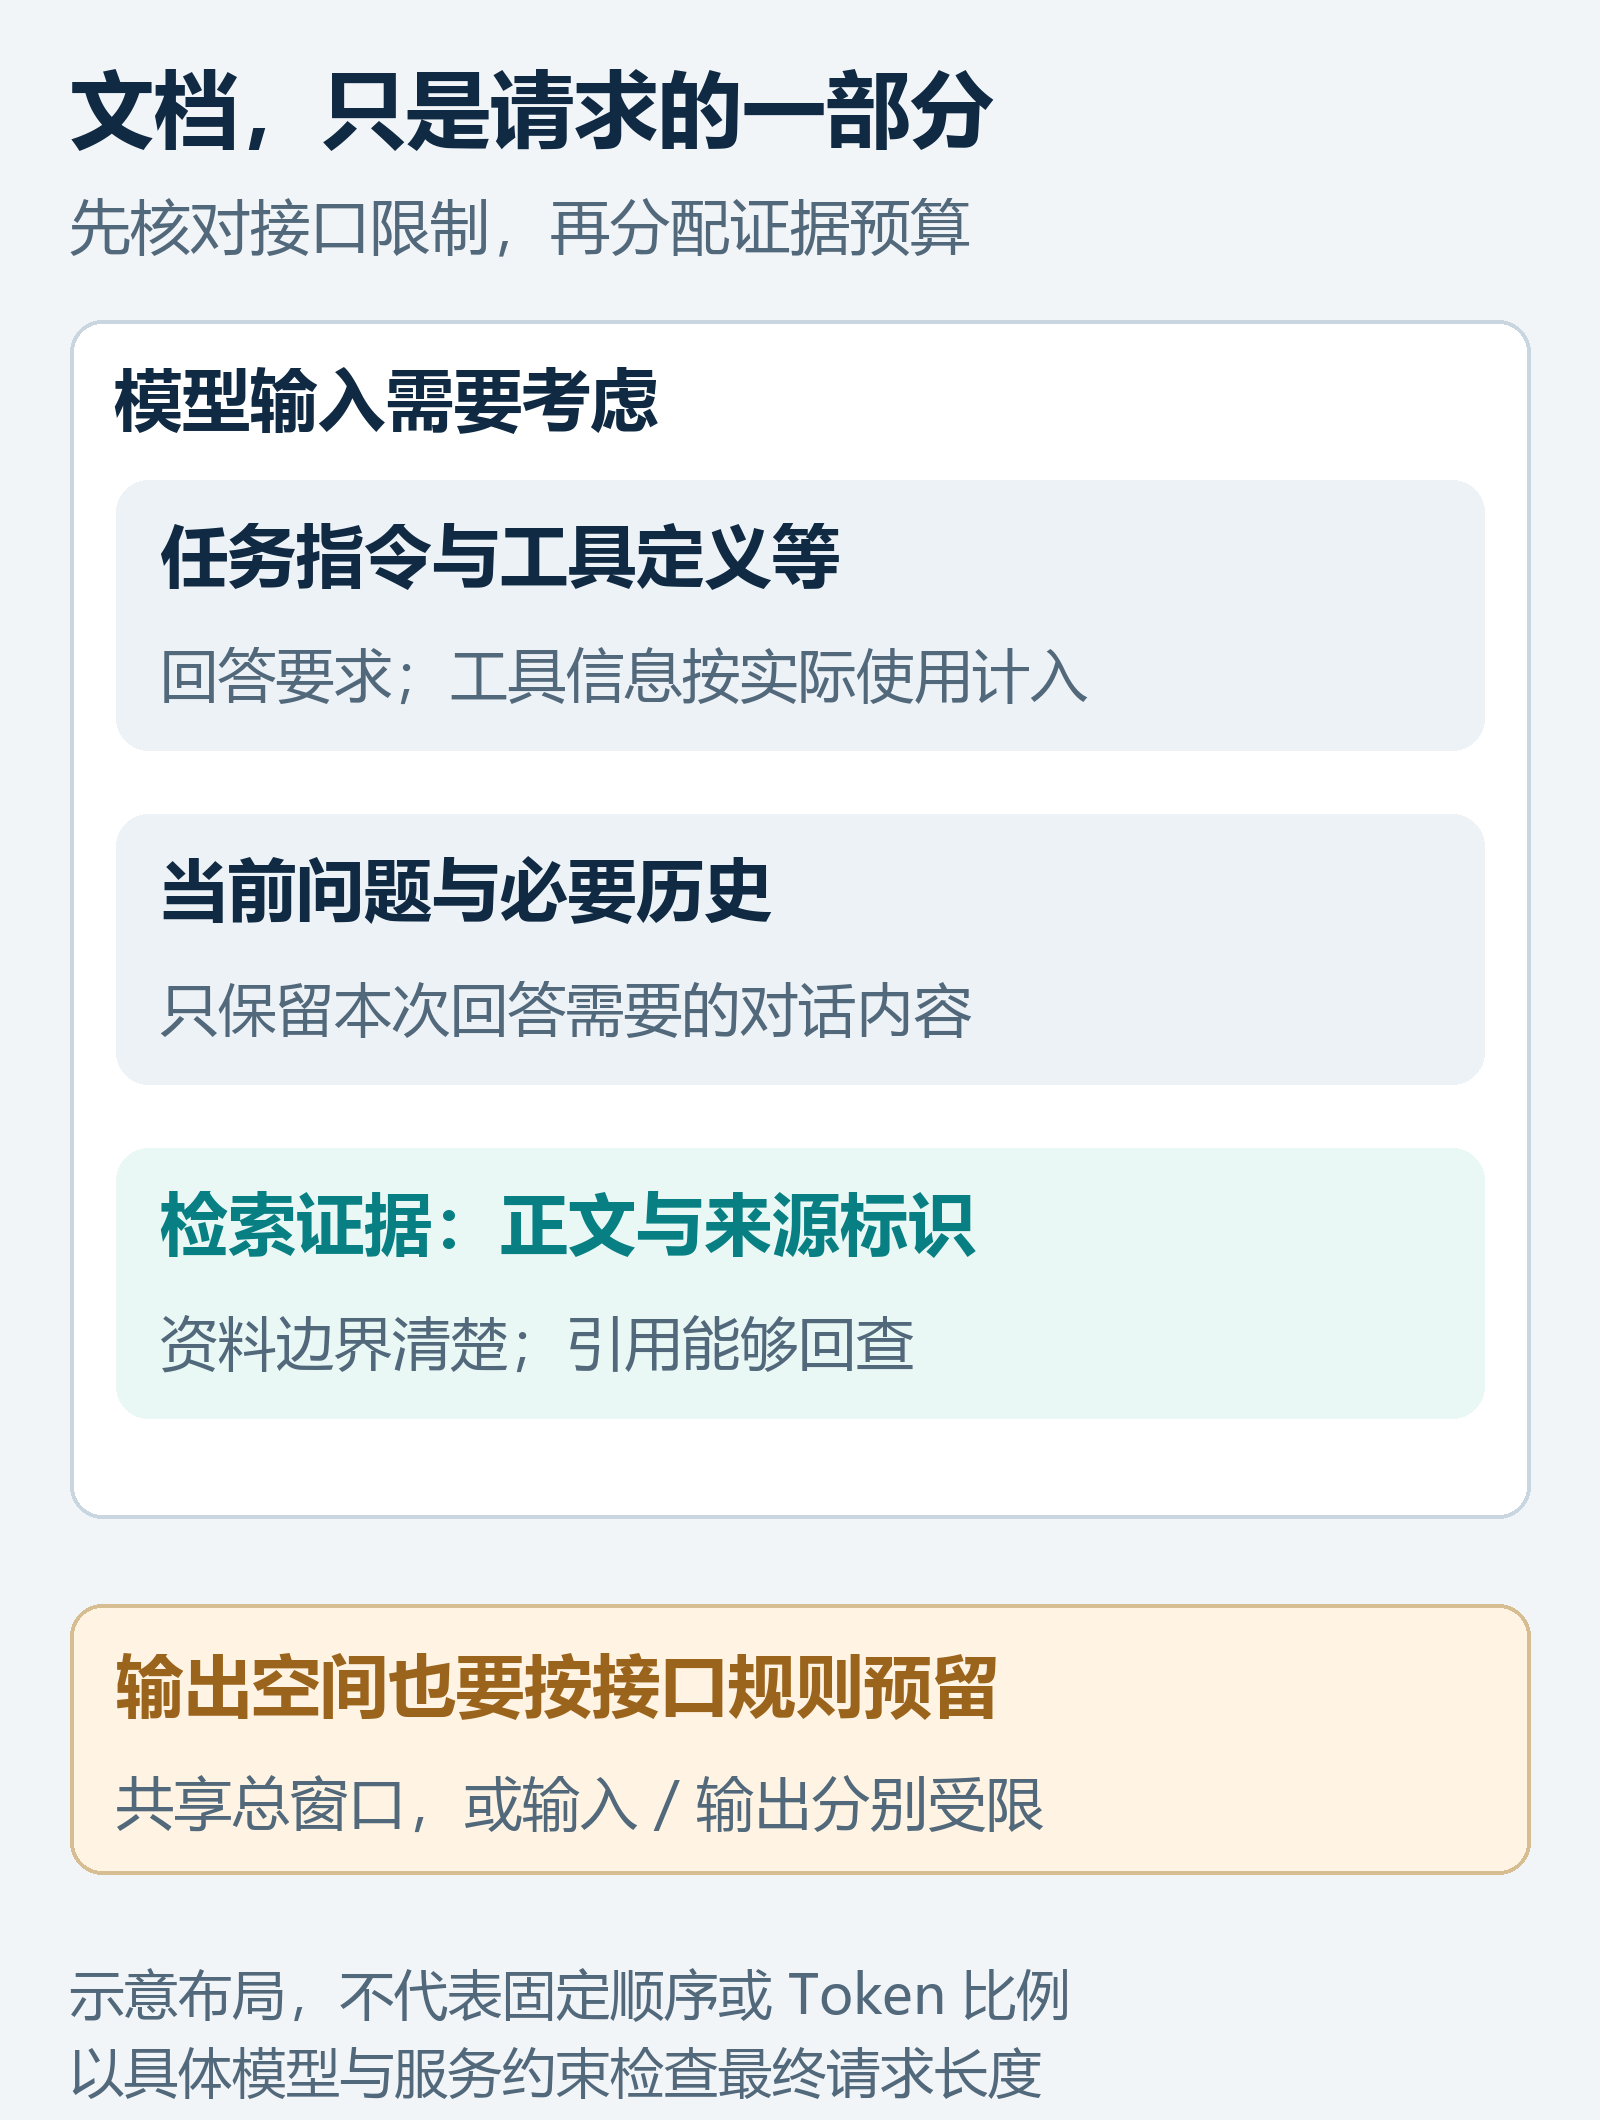
图 2:展示需要考虑的内容,不表示固定顺序、固定比例或所有接口共用一种长度限制。
预算不足时,优先移除无关、重复内容,再缩小证据范围或调整检索。不要依赖接口替你截断:即使请求没有报错,也要检查关键依据是否还在。
四、让模型分清指令和参考资料
上下文里至少要分清三件事:这次要回答的问题、回答需要遵守的规则,以及用于支持回答的外部材料。
参考片段可以保留稳定的来源标识、文档标题、版本、页码或章节位置,并与正文一起传入。只把这些信息存进数据库元数据,模型未必能看到它们。
外部文档里的命令式语句,不应自动成为应用要执行的指令。清楚划分资料边界有帮助,但分隔符、标签或一句“忽略文档指令”,都不能单独保证阻止提示注入。访问权限和工具能力仍需由应用代码限制。[3]
五、引用要能回查,还要支持结论
可以给送入上下文的片段分配引用标识,由应用维护标识与原文位置的对应关系。回答引用这些标识,展示链接或定位信息时再查映射,不让模型自由编造页码和网址。
还需要区分两层检查:
- 引用是否有效:标识存在,确实能定位到提供过的材料。
- 引用是否支持结论:该位置的内容,是否足以支撑回答中的那句话。
部分模型接口提供结构化引用,可返回文档及位置指针。[4] 但有了合法指针,不等于文档内容真实,也不等于回答没有扩大原文的适用范围。
资料互相冲突时,保留版本、时间和来源差异;无法确认哪一条适用,就把不确定之处说清楚,不能合成一个看似一致的结论。
六、材料的排列顺序也要检查
精排顺序可以作为起点,但未必就是最合适的阅读顺序。若多个片段共同解释一件事,可以评估按同一来源、章节或必要的先后关系组织材料,同时保留相关性与出处。
《Lost in the Middle》在其测试的模型与任务中发现,相关信息的位置会影响利用效果,长上下文中部尤其可能被忽略。[5] 这提醒我们检查位置影响,但不能据此把“重要内容永远放开头或结尾”当成所有模型的固定规则。
需要用实际采用的模型与问题验证,而不是把重排步骤当作必然有效的技巧。
七、怎样检查这一步有没有做好?
先固定候选片段、生成模型和任务指令,比较不同组织方式,逐项看:关键依据是否齐全,条件是否被保留,引用能否定位并支持结论,以及请求长度、响应时间和成本有何变化。
同时保留最终实际发送的上下文用于受控排查,而不只记录原始检索列表。敏感材料的记录范围、访问权限和保留期限,也要按应用要求设置。
面试时可以这样概括:
RAG 上下文组织是在检索后选择、去重并编排证据,按模型与接口约束控制长度,保留适用条件和来源标识,再与问题、任务指令一起提供给模型。它要兼顾证据覆盖、引用支持和外部资料边界;不能用片段更多、窗口更大或回答更流畅,代替实际的质量检查。
这一步完成的标志,不是“材料都放进去了”,而是模型收到的材料足够回答当前问题,而且回答依据能被核对。
参考资料
- LangChain:Context engineering——单次模型调用中的指令、消息、工具与上下文。
- Google:Understand and count tokens——Token 计数与输入输出用量。
- OWASP:LLM01 Prompt Injection——外部资料边界与权限约束。
- Anthropic:Citations——结构化引用及原文位置指针。
- Liu 等:Lost in the Middle——长上下文信息位置与使用效果的研究。
- 李博杰,《深入理解 AI Agent:设计原理与工程实践》,v1.2(2026-07-22),第 2 章 §2.2.5,书内 36–37 页(PDF 44–45 页)——上下文构成的补充阅读。
- 题库第 236 题:RAG 系统如何标注信息来源和提供引用?——来源与引用部分的选题参考。
评论交流
欢迎留下你的想法