知识库里明明写着“扫描版 PDF 需要先做 OCR”,为什么机器人仍然回答“支持 PDF,可以直接上传”?
原因可能出在资料进入知识库时的切分方式:一句规则和它的限制条件,被切到了不同的块里。 如果检索只拿回前半句,后续回答就少了一条关键依据。
上一篇介绍了 RAG 的整体流程。这次把其中的“分块”单独拿出来,看它到底改变了什么。
一、分块到底在做什么?
分块(Chunking),就是把长文档拆成便于检索和使用的内容片段。在常见的向量检索方案中,每个块会生成对应的向量,并与原文、来源等信息一起保存。
用户提问时,系统先找相关片段,再把选中的资料交给模型。切分边界会影响检索拿到的证据是否完整。
为什么不把整份文档当成一个块?
文档过长时,可能超过嵌入模型的输入上限。
同一份手册可能混合上传、账户、计费等话题。整篇用一个向量表示,未必方便定位某条具体规定。
把整篇都交给生成模型,会占用更多上下文,也带入更多无关材料。
但分块不是必须执行的仪式。一条简短、独立完整的 FAQ,本身就可以作为一个块。 关键是内容能否清楚表达、方便检索,并满足所用模型的输入限制。[1]
二、同一份手册,三种切法
继续使用虚构的《文档助手说明书》。以下规则仅用于教学,不代表实际产品功能:
文件上传
支持 PDF、TXT 和 DOCX,单个文件不超过 20 MB。
扫描版 PDF 需要先完成 OCR,转换为可提取文字的文档后再上传。账户设置
用户可以修改昵称和头像。
现在问:“扫描版 PDF 可以直接上传吗?”
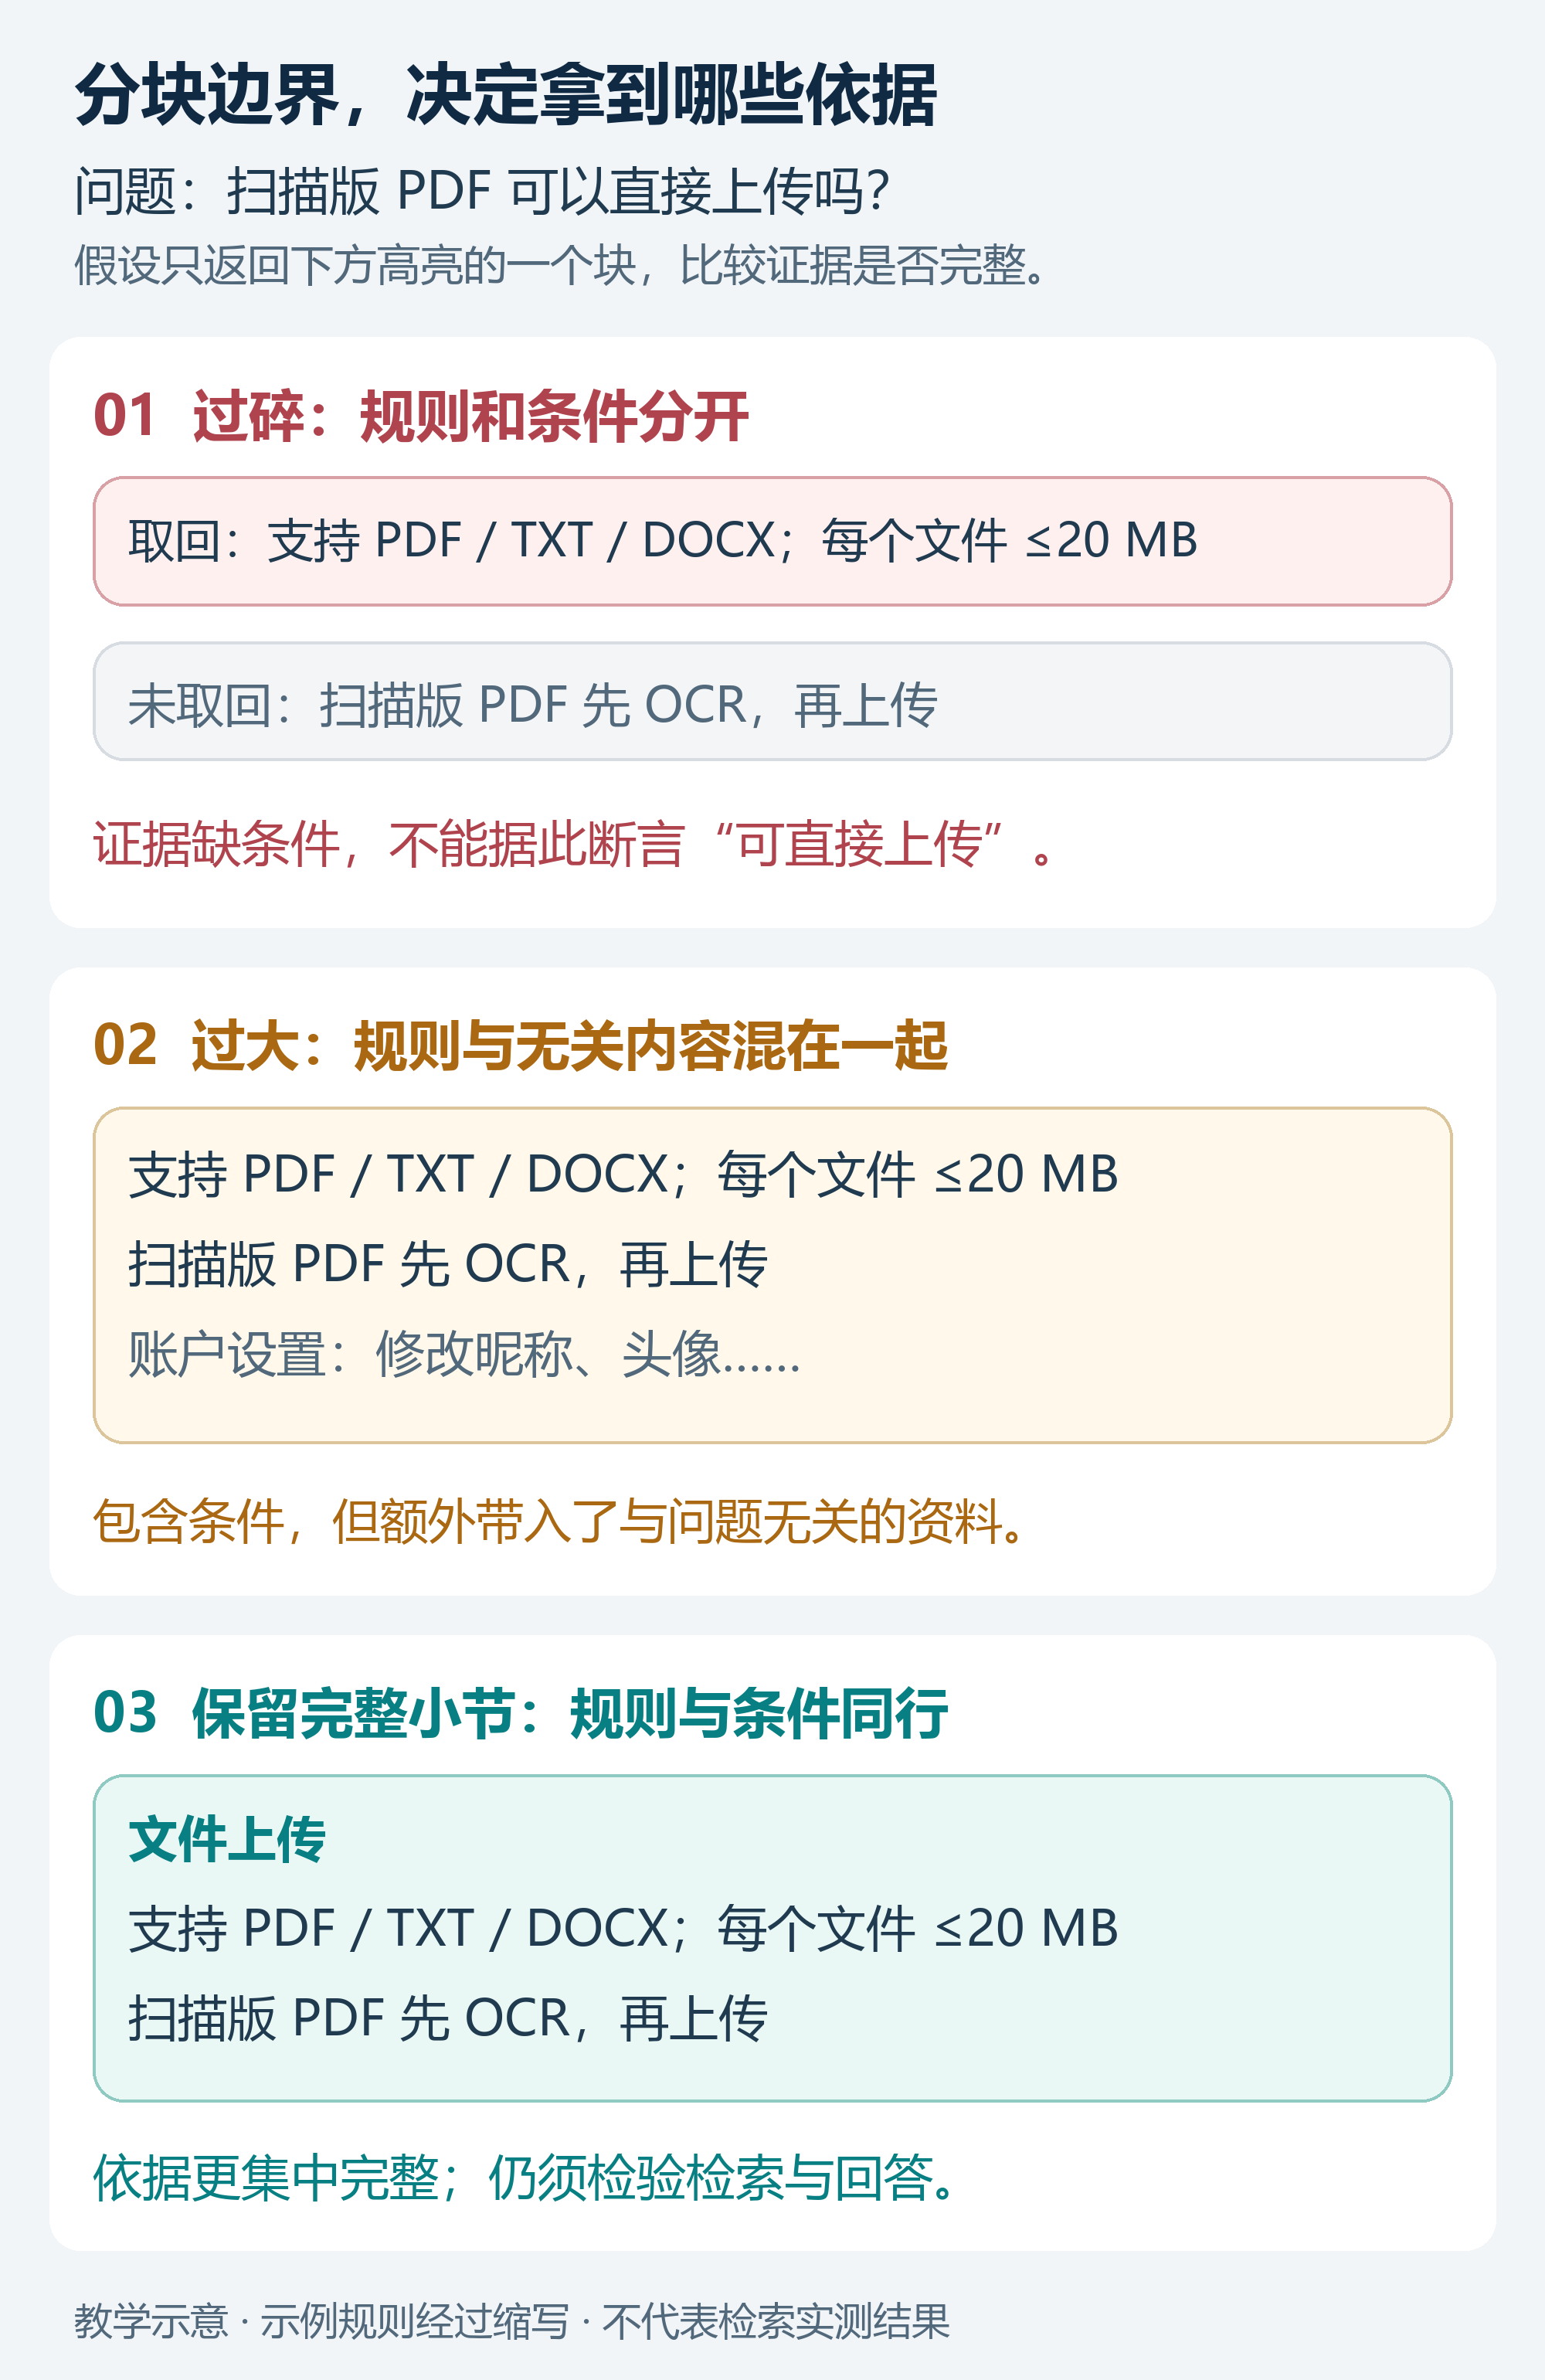
图 1:假设检索只拿回图中高亮的一个块,观察它包含哪些依据。此图是教学示意,不是检索实验结果。
切得过碎:规定找到了,条件没跟上
如果“支持 PDF”和“扫描件需先 OCR”分别属于两个块,而检索只返回第一个块,模型就没有得到扫描件的完整规则。
这时,合理的处理是承认资料不足;如果模型自行把“支持 PDF”扩展成“所有 PDF 都能直接上传”,就会答错。不能指望模型猜出没有送到它面前的限制。
切得过大:能读到条件,也带入了噪声
如果整本手册都放进同一个块,扫描件条件可能确实保住了,但昵称、头像等内容也一起进入上下文。
这不意味着大块一定答错,而是检索粒度更粗、输入可能更冗余。实际效果还受文档结构和问题类型影响。
保留一个完整意思:让规则和条件一起出现
在这个例子中,可以把“文件上传”小节作为一个块,让格式、大小上限和扫描件条件一起出现,把“账户设置”另存一块。
这样得到的是一份更完整、也更集中的回答依据。它仍不保证检索一定命中,也不保证模型一定正确使用,但避免了切分本身先把条件拆散。
三、别只留下正文,还要留下出处
文档切完之后,片段往往会脱离原来的页面。只看到“需要先完成处理”,读者和模型都很难知道处理什么、依据在哪里。
可以为上面的块保留这些信息:
文档:《文档助手说明书》
章节:文件上传
定位:第 3 页
内容:支持格式、20 MB 上限、扫描件 OCR 条件
标题可以帮助理解主题,页码或章节位置方便回查原文。只把标题存进元数据还不够:如果回答时需要它,就要确保检索和上下文组织环节实际使用了它。
同时,分块不能补回解析时已经漏掉的内容。原始 PDF 的脚注、表格条件若没被提取出来,后面换多少块大小都解决不了。
四、块大小与重叠,该怎么理解?
chunk_size 通常控制块的大小,但单位取决于实现:可能是字符,也可能是 token。两者不能直接画等号,中文尤其不适合套用固定的换算比例。[2]
chunk_overlap 表示相邻块共享一部分内容,目的是缓解边界处的上下文断裂。
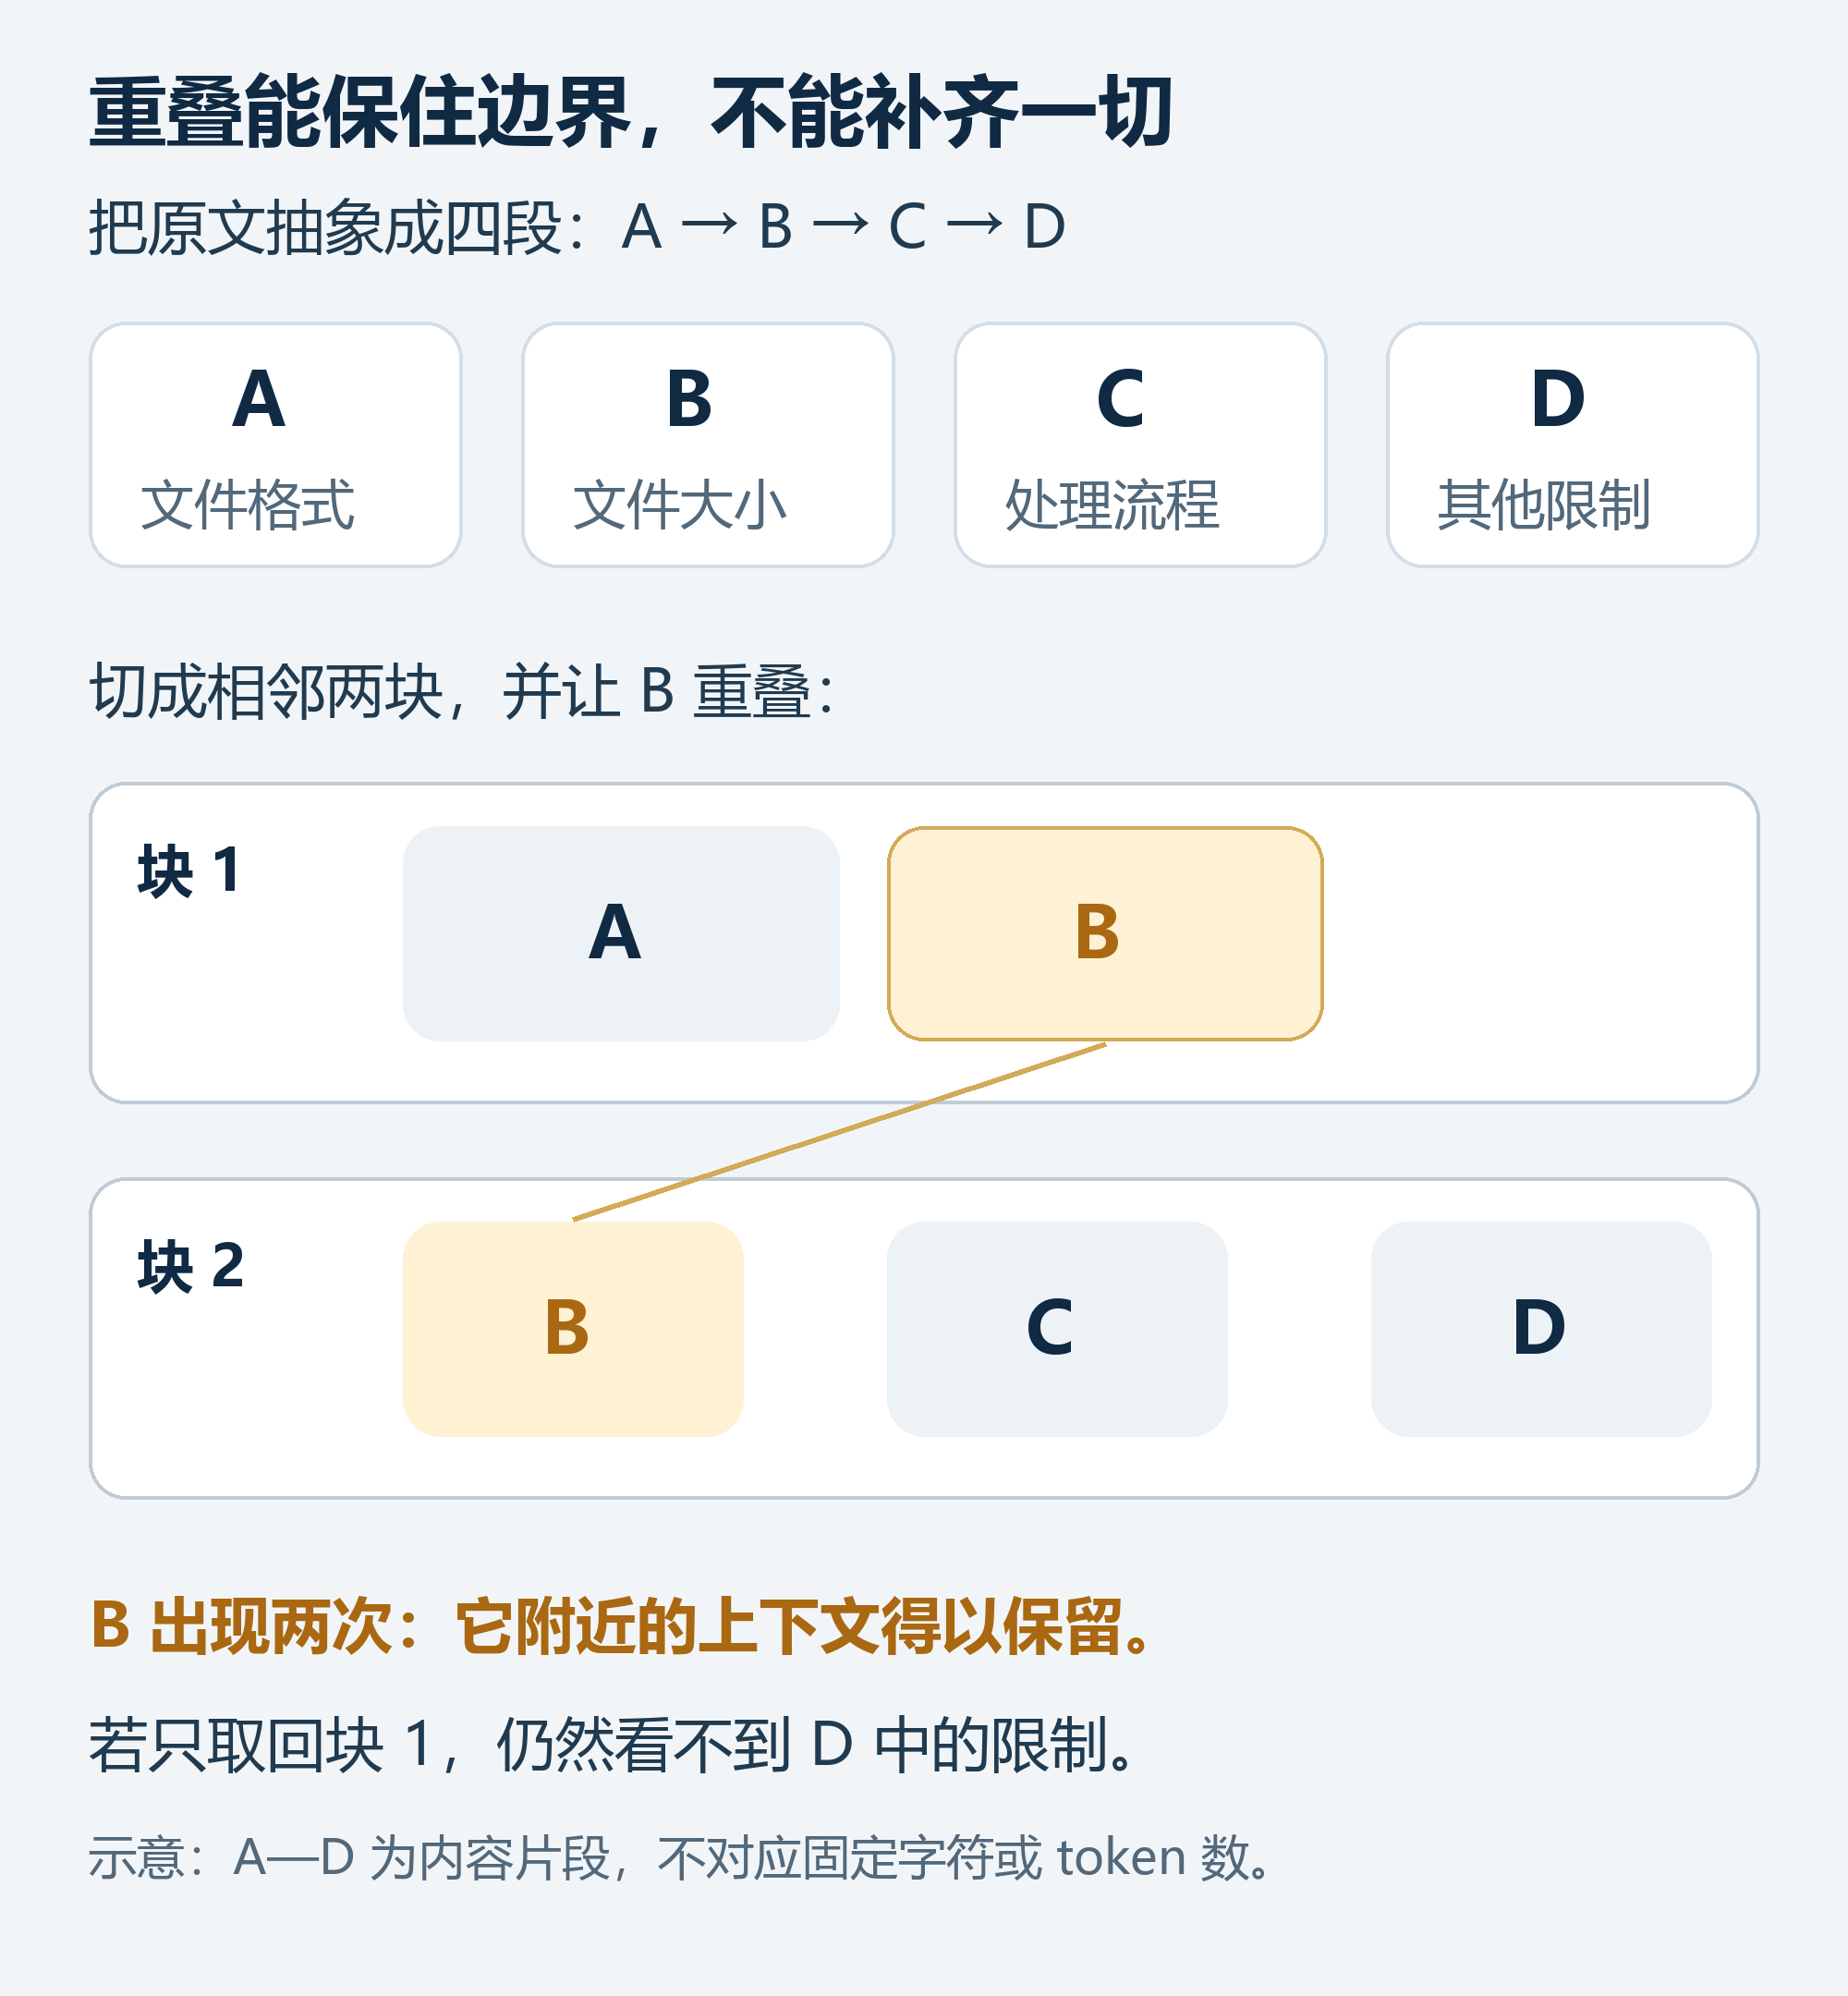
图 2:B 同时出现在前后两个块中;与它相隔较远的 D,不会因此自动进入第一个块。
重叠有帮助,但也有代价:重复内容需要再次存储、嵌入,检索结果中也可能出现相近片段。[3] 如果限制条件远在文档另一处,只重叠边界上的一小段文字,仍然覆盖不到它。
所以,不能把“512 tokens”或“重叠 20%”当成所有知识库的标准答案。结构清楚的手册、零散 FAQ、长篇叙述,适合的设置可能不同。
五、初学者可以怎样起步?
先做一个容易检查的版本:
检查解析结果:原文中的标题、正文和限制条件是否都在。
先尊重结构:优先按小节、段落组织内容;超过长度限制时再继续拆分。处理中文时,注意句号、逗号等分隔符。[2]
保留来源:记录文档名、章节和定位信息,必要时附到实际检索文本及模型上下文中。
用真实问题核对:既问“支持哪些格式”,也问“扫描件有什么限制”。逐条查看检索结果,而不只看最终回答是否流畅。
比较不同切法时,先固定检索和生成配置,再观察:关键依据是否齐全、无关内容是否过多、上下文是否超限。切块、召回数量和模型同时改动,就很难判断改进来自哪里。
六、面试时可以怎样回答?
分块是把长文档组织成便于检索和放入模型上下文的片段。它能帮助满足输入长度限制,并让检索定位到更具体的内容。块过小可能拆散规则与条件,块过大可能混入无关信息。实践中应结合文档结构、模型限制和真实问题选择边界,保留标题与来源,必要时设置适量重叠,并通过检索结果检查证据是否完整。
分块首先要解决的是:找到一段话时,能否同时读懂它的适用条件。 下一篇再比较固定长度、递归切分、按标题切分等常见方法。
参考资料
Microsoft Learn:Chunk large documents for RAG and vector search——输入长度、内容结构与分块取舍。
LangChain:Splitting recursively——长度函数、重叠参数及中文分隔符。
Cloudflare AI Search:Chunking——重叠的用途及索引开销。
评论交流
欢迎留下你的想法