搜索“RRF”和“怎样合并两路检索结果”,可能是在寻找同一类知识,却提供了不同的检索信号:前者有明确的算法缩写,后者用自然语言描述目的。
上一篇介绍了 Embedding 怎样帮助问题找到语义接近的片段。这次接着看:如何同时利用词项匹配和语义匹配,让不同问法都有机会找到依据?
一、关键词和自然语言,提供不同信号
“RRF”这样的算法缩写适合利用词项匹配:查询与资料中出现同一术语,是一个有价值的信号。
“怎样合并两路检索结果”没有直接写出算法名称,系统还需要把问题与“排名融合”等表述联系起来。向量检索可以利用这种语义联系。
关键词路可以利用前一种信号,向量路可以补充后一种信号。两者都可能找到好结果,也都可能漏掉关键片段,不能简单判定某一路总是更强。
二、BM25 在找什么?
常见的关键词检索会先把文本分析成词项,再通过倒排索引定位包含这些词项的片段。BM25 是其中一种排序方法,综合考虑词频、词项在文档集合中的稀有程度,以及文档长度等因素。[1]
因此,产品型号、题号、错误码和专有名词值得交给关键词路比较。但这里的“词项匹配”不等于整句完全一致,也不保证错误码一定被正确保留。
例如算法缩写、产品型号若被不合适地拆分,或查询与文档的规范化方式不同,效果就可能打折。中文分词、大小写、连字符和别名处理,都应检查。需要严格限定某个型号或编号时,可以设计专门字段或精确过滤,不能只依赖 BM25 排名。
向量路则依据模型形成的表示寻找接近内容。“合并检索结果”和“排名融合”可能被联系起来,但讨论精排的相关段落也可能进入候选。话题相近,不等于这段内容正好回答了问题。
三、混合检索怎样组合两路结果?
本文讨论一种常见方案:分别运行 BM25 和稠密向量检索,再将候选融合。混合检索也可以有其他组合,这里先把最基本的流程讲清楚。
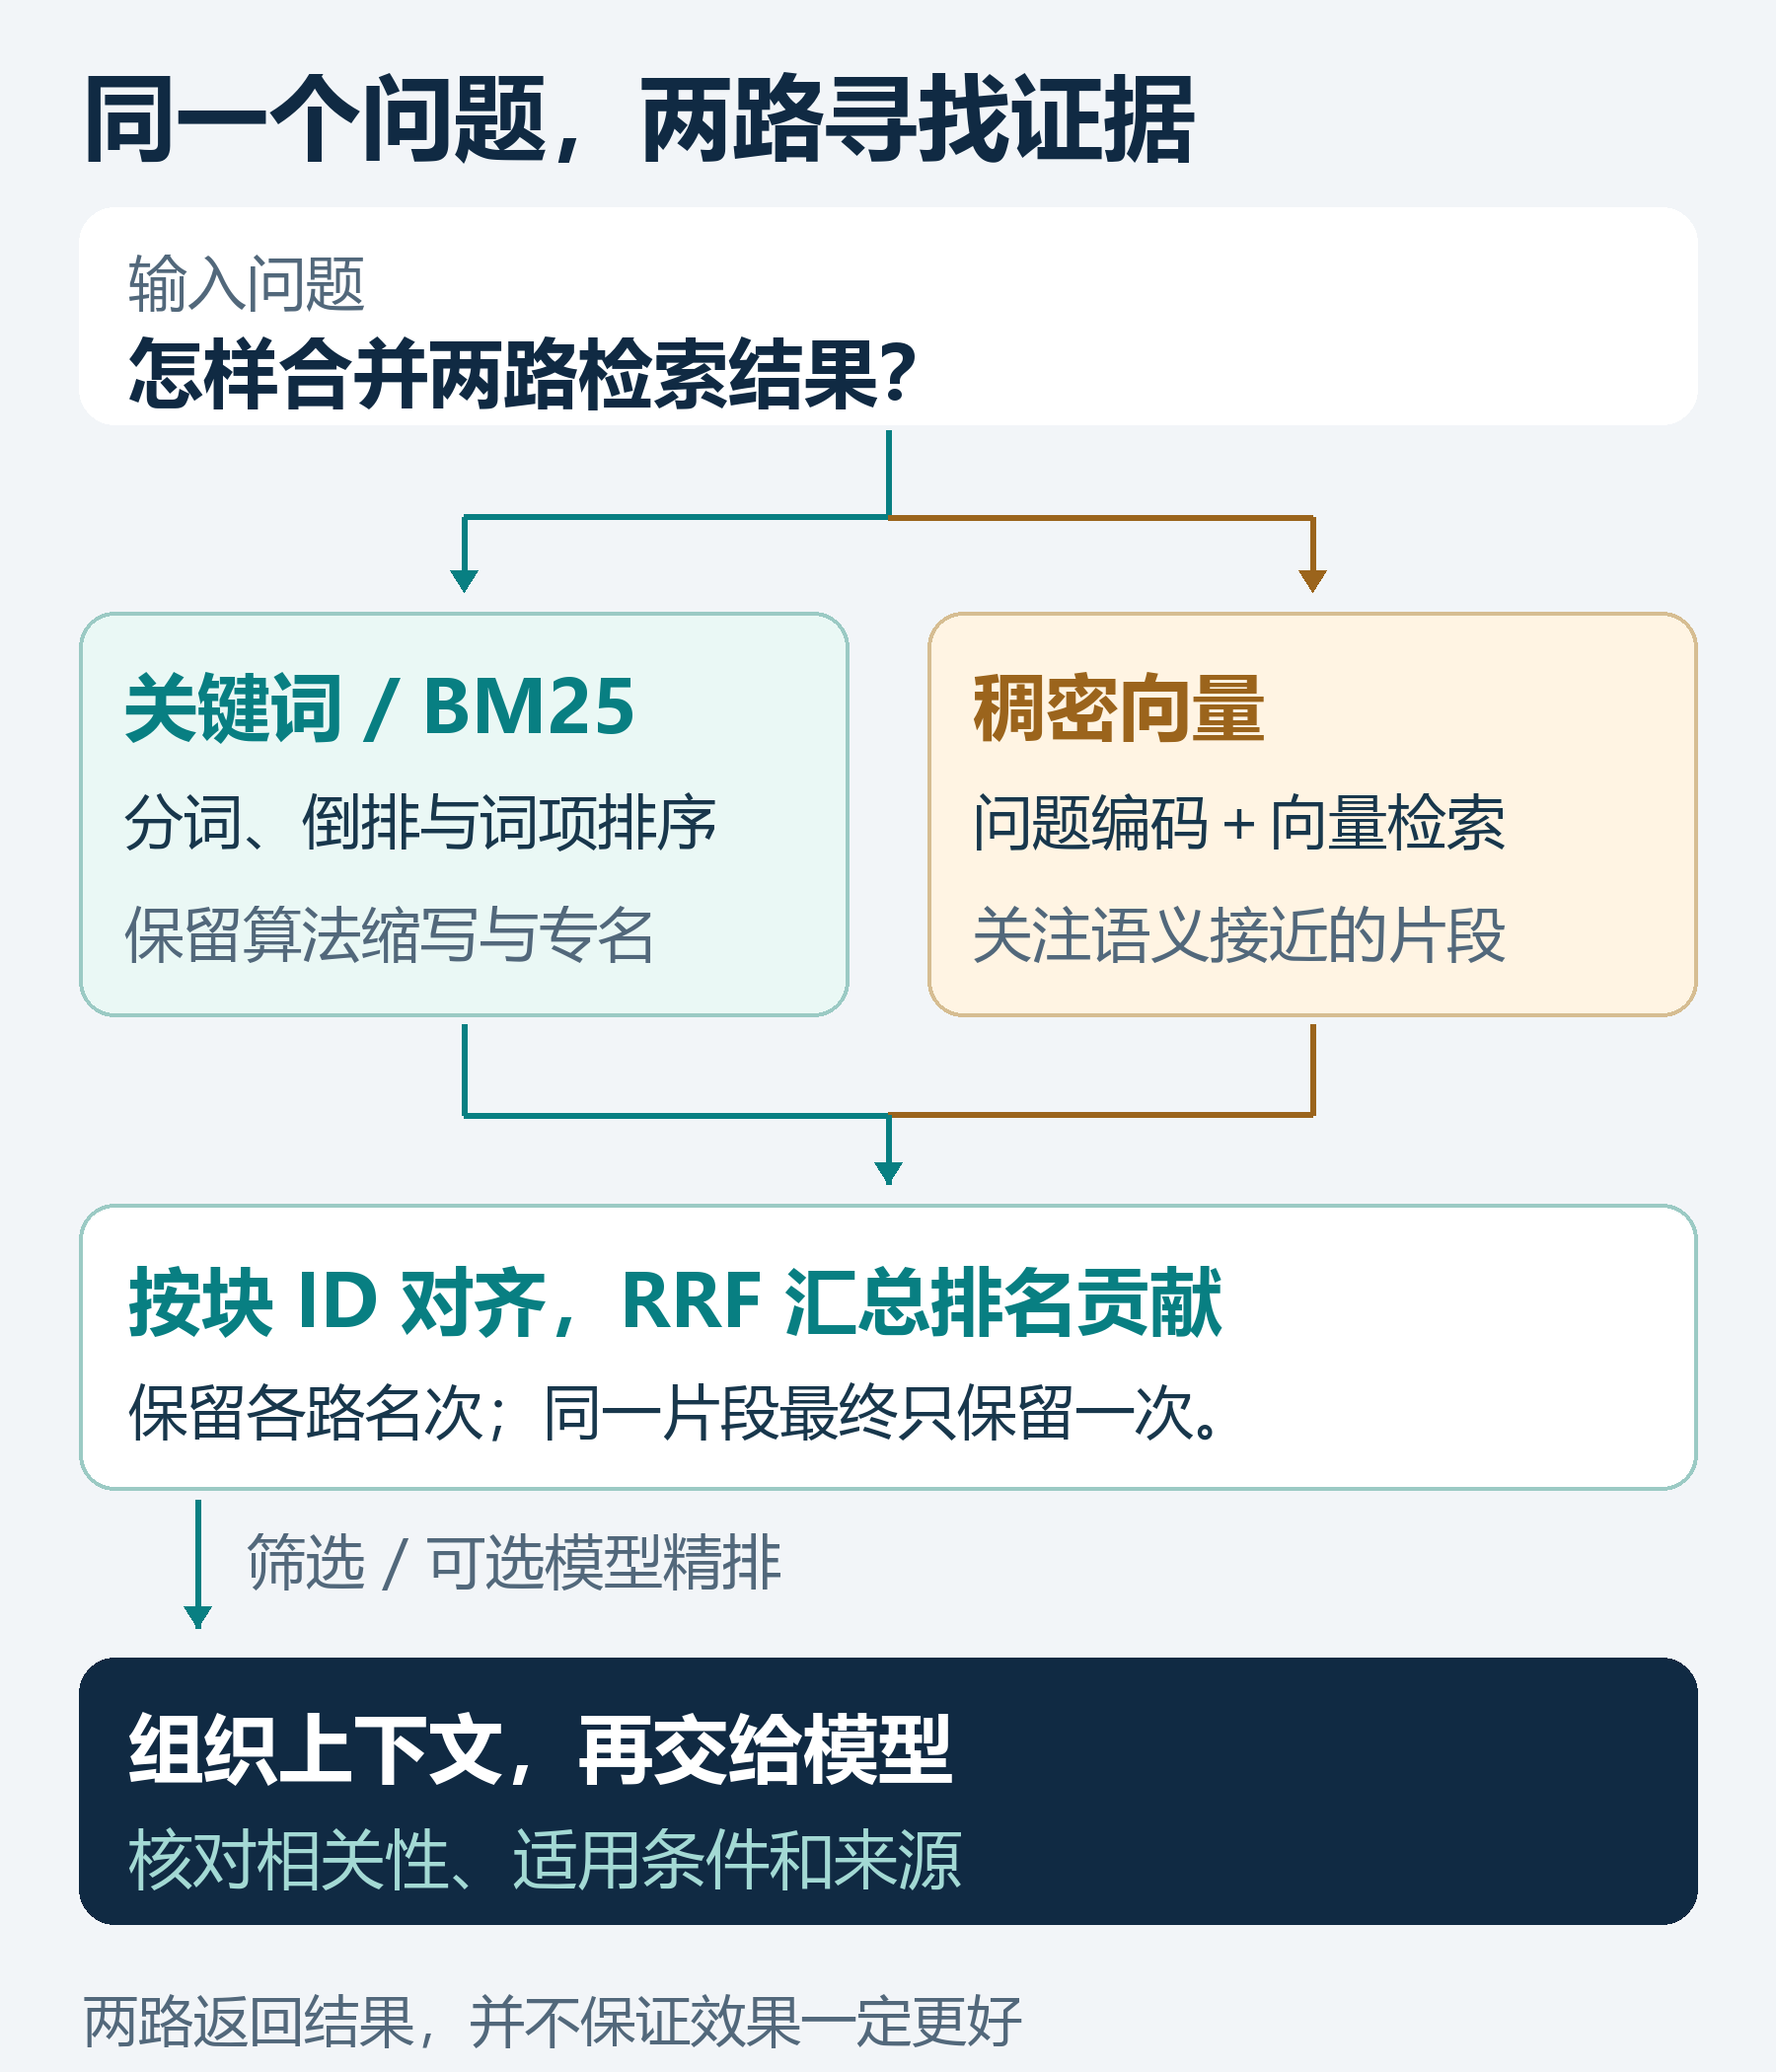
图 1:两路共享同一套片段标识;同一片段出现两次时,融合应保留两路的排名贡献,最终只作为一个候选。
两路需要对齐到同一批可追溯的片段,例如共同使用 chunk_id、来源和版本信息。两边的更新状态、过滤条件也要保持一致,避免一边返回新手册,另一边还在检索旧规则。
但把两个列表拼起来还不够。BM25 分数与向量相似度的含义、尺度不同,直接把原始分数相加,可能让某一路仅因数值较大而主导排序。 可以评估归一化后的加权融合,也可以先试基于排名的 RRF。[2]
四、RRF:用名次汇总贡献
RRF(Reciprocal Rank Fusion,倒数排名融合)的一种等权形式可以写成:
某片段的融合分数 = 各路 1 / (c + 该路名次) 的和
名次从 1 开始;某路没有返回该片段,这一路不贡献分数。c 是平滑常数,不是召回数量。[2][3]
只看排名计算,用 A、B、C 表示三个候选片段:
- BM25 路:A、C、B。
- 向量路:B、A、C。
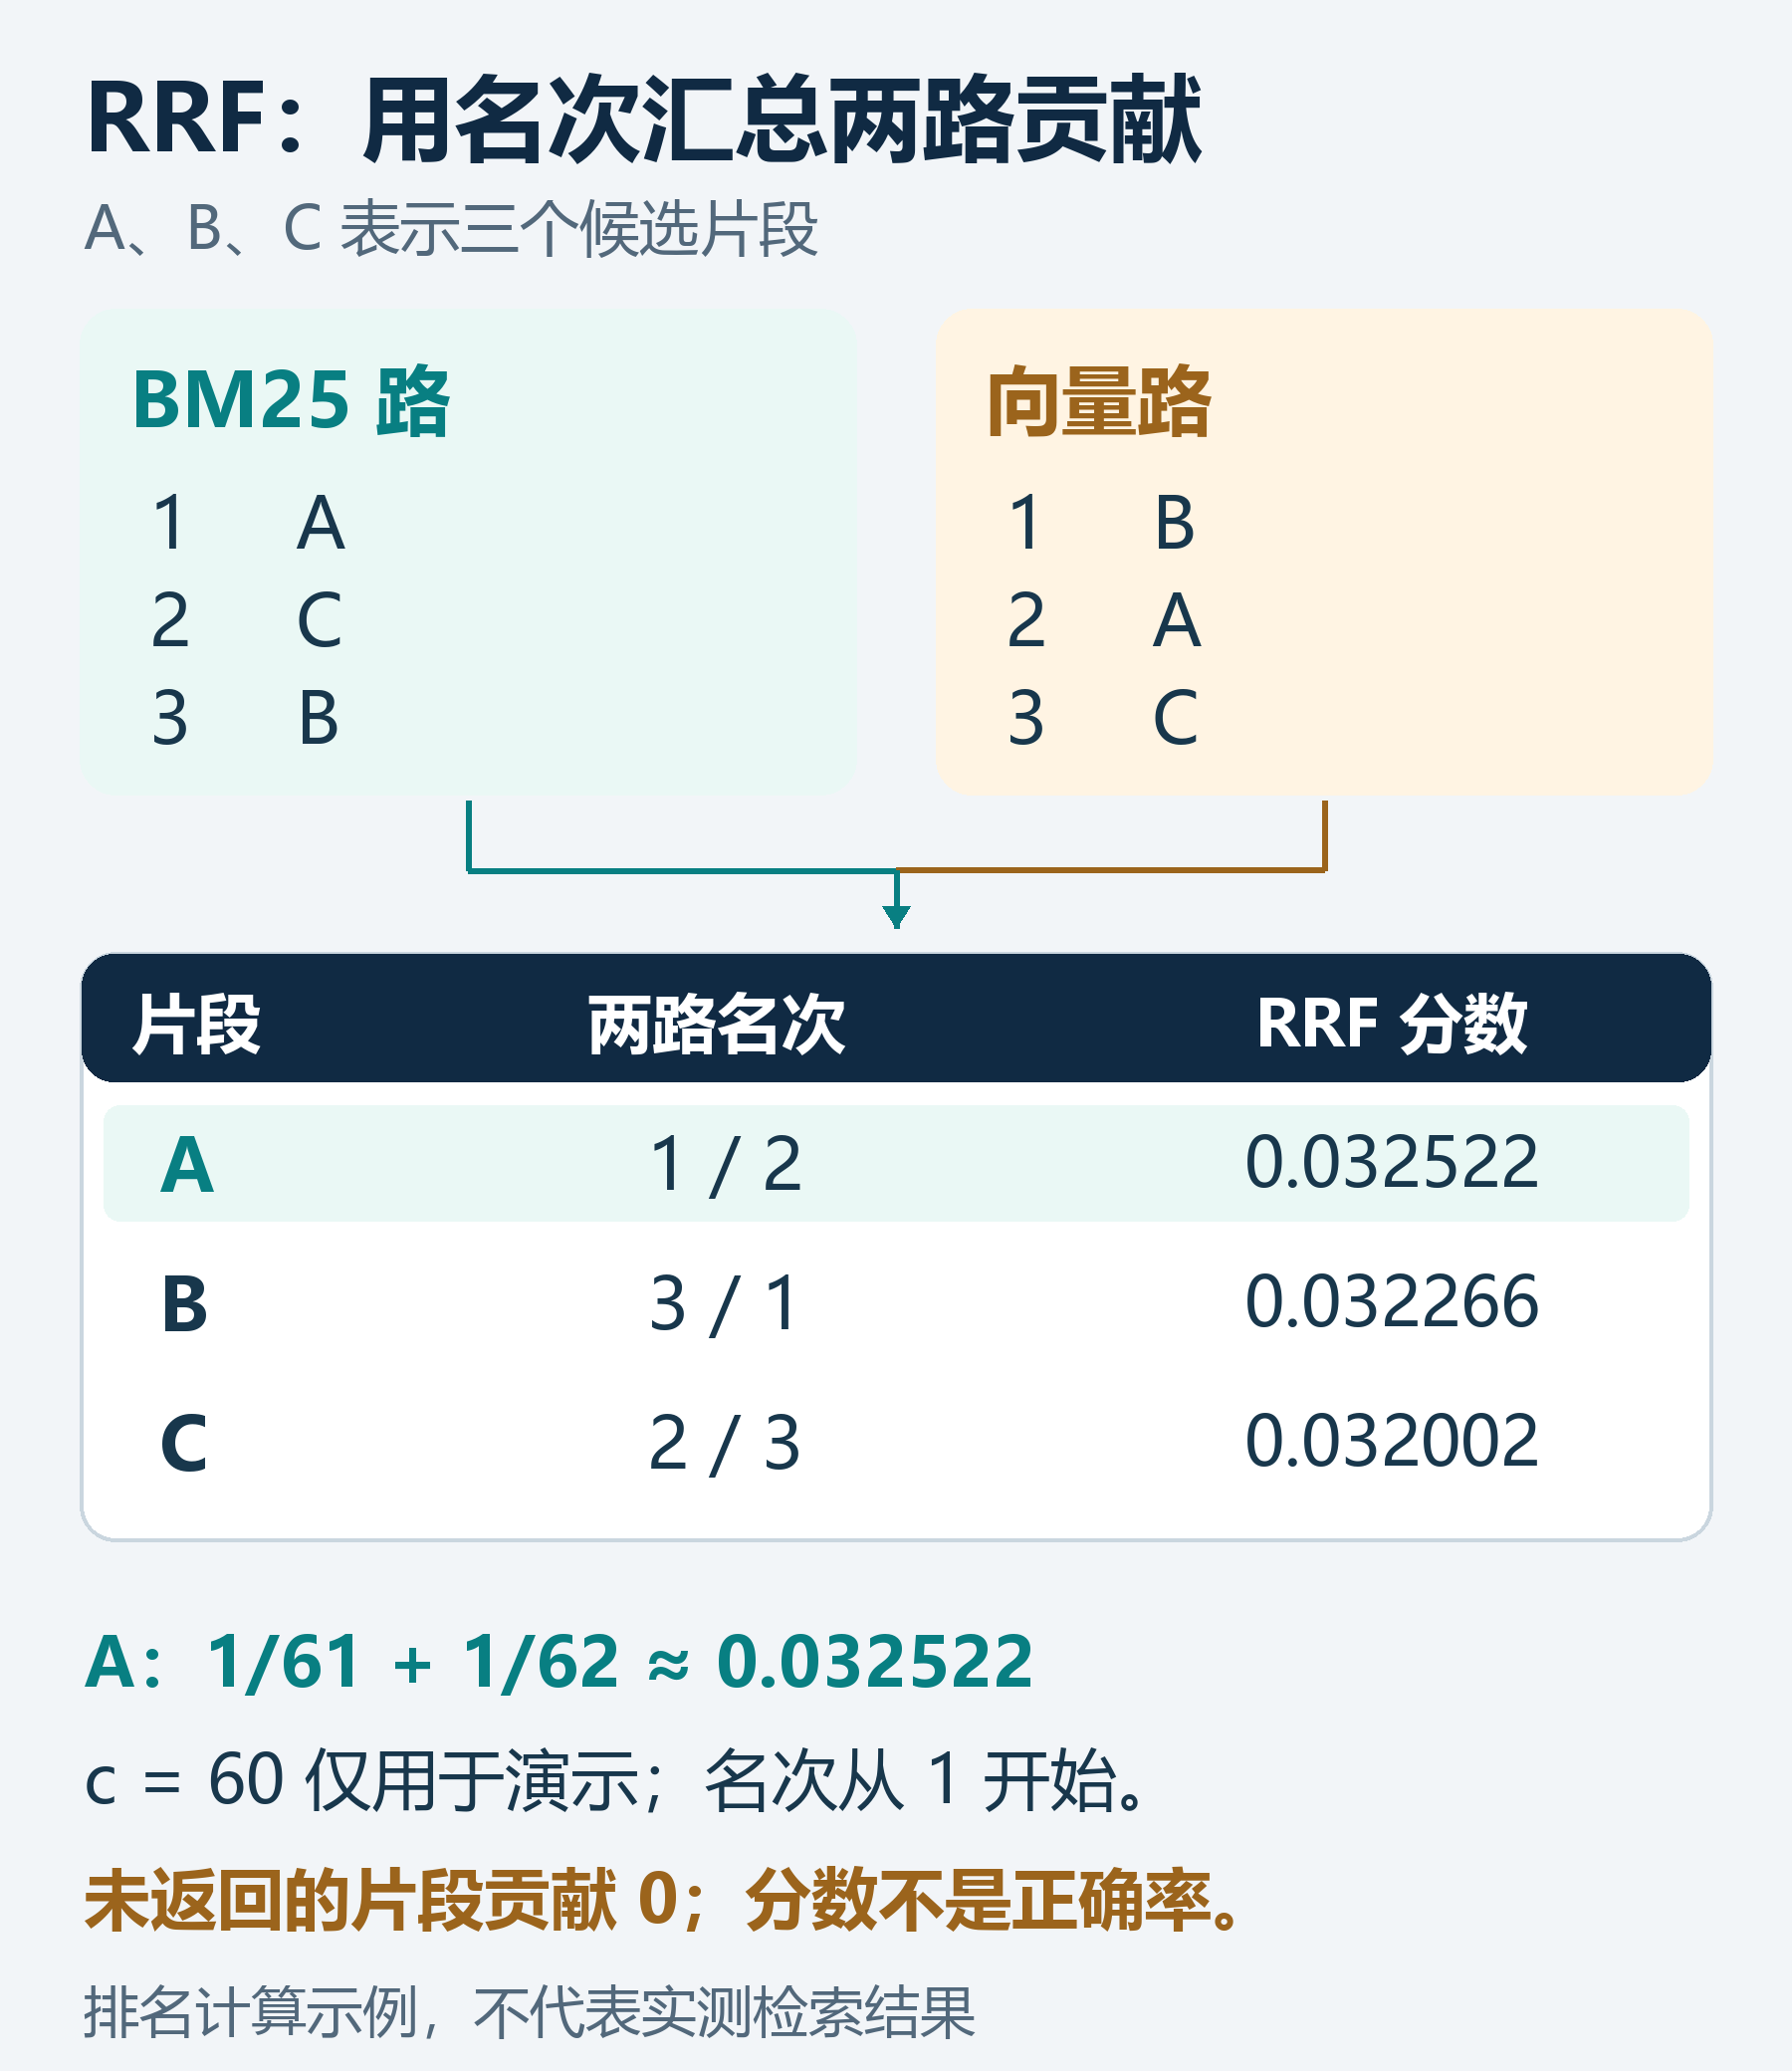
图 2:这里只演示 RRF 的计算方式,名次不代表实测检索结果,分数也不是正确率。
取 c = 60,A 的分数为 1/61 + 1/62 ≈ 0.032522,最终次序是 A、B、C。这个常数只用于本例;实际仍要评估参数、每路候选数量与最终保留数量。[3]
RRF 不要求两路原始分数可比,但会舍弃分数差距的信息:某一路第一名比第二名高很多,和只高一点,在名次相同时贡献一样。融合排第一,也不等于已经核实规则正确。
五、融合之后,还要精排吗?
可以根据需要增加精排。融合负责把不同来源的候选组织成一个排序;常见的模型精排器会进一步联合评估问题与候选文本的相关性,通常比第一阶段逐项打分更费计算。[4]
精排并非每个入门系统的必选项,也无法找回完全没进入其候选池的材料。最后仍要检查所用片段是否回答了当前问题,而不是只谈到了相近的概念。
同样,RRF 不负责决定访问权限、规则版本或答案是否可信。这些条件应在检索及后续处理过程中明确维护。
六、怎样判断混合检索有没有帮助?
先用相同的问题集,比较三组结果:关键词单路、向量单路、混合检索。问题至少覆盖:
- 带缩写或专名:“RRF 的作用是什么?”
- 自然语言改写:“怎样合并两路检索结果?”
- 易混淆的相邻概念:“RRF 融合与模型精排有什么区别?”
记录正确证据是否进入候选、排在什么位置、重复与无关内容有多少,并同时观察响应时间。比较最终回答时,保持上下文预算等条件一致;否则,“送入更多文字”带来的变化容易被误认为融合方法本身的收益。
如果两路长期返回同样的好结果,新增一路的收益可能有限;如果它们互补,也要确认融合后真正有用的片段没有被挤出最终上下文。两路都返回了结果,并不能证明效果更好。
七、面试时可以怎样回答?
RAG 混合检索通常结合关键词召回与向量召回,利用词项和语义两类信号。各路结果按稳定的片段标识对齐,再用 RRF 或经过尺度处理的分数融合得到统一候选,必要时再精排。实施时要关注分词、两路数据一致性、候选数量与上下文预算,并用同一组真实问题验证收益,不能保证混合后一定更好。
下一步如果遇到“正确材料已经找到了,却排得不够靠前”,就可以继续研究精排器怎样判断问题与片段的相关性。
参考资料
- Elastic:How full-text search works——文本分析、倒排索引与 BM25 排序因素。
- OpenSearch:Reciprocal rank fusion——原始分数的尺度、排名融合与取舍。
- Elastic:Reciprocal rank fusion——RRF 公式、名次与候选窗口。
- Sentence Transformers:Retrieve & Re-Rank——召回与精排的职责。
- 李博杰,《深入理解 AI Agent:设计原理与工程实践》,v1.2(2026-07-22),第 3 章 §3.2.4,书内 85–86 页(PDF 93–94 页)——混合检索与重排序的补充阅读。本文未复用书中图表或示例数值。
- 题库第 5 题:什么混合检索?在基于大模型的应用开发中,混合检索主要解决什么问题?、第 367 题:什么是 RAG 混合检索?如何实现向量检索和关键词检索结合?——选题参考。
评论交流
欢迎留下你的想法