上一篇讨论了怎样把文档切成适合检索的片段。块已经准备好,下一个问题是:用户换一种说法,系统怎么找到相关材料?
继续使用虚构的《文档助手说明书》。其中一块写着:
支持 PDF、TXT 和 DOCX。扫描版 PDF 需先完成 OCR,再上传。
用户却问:“拍照扫成的 PDF 能直接传吗?”
问题与原文没有逐字对应,但讨论的是同一件事。在采用向量检索的 RAG 中,Embedding 用来把这样的文本转换为可比较的表示。它帮助寻找候选材料,后面仍要读取原文、核对条件并生成回答。
一、Embedding 把什么变成了什么?
Embedding,常译为“嵌入”,在这里可以理解为:用模型把一段文本编码成一串数字,也就是一个向量。
例如,一段上传规则可以表示成 [0.12, -0.37, 0.08, …]。这些数字只是表示形式的示意,不是某个模型的真实输出。
模型通过训练学习怎样组织这种表示,让适合当前任务的相关文本更容易被匹配。向量各维通常不能直接解释成“第一个数表示文件格式,第二个数表示上传权限”,也不宜把它想成逐项可读的关键词表。[1]
需要区分的是:Embedding 模型提供用于匹配的表示,回答模型根据问题与证据组织答案。 它们承担不同任务,不要求使用同一个模型。
二、文档向量提前准备,问题向量随提问生成
把两条链路分开看,会更清楚:
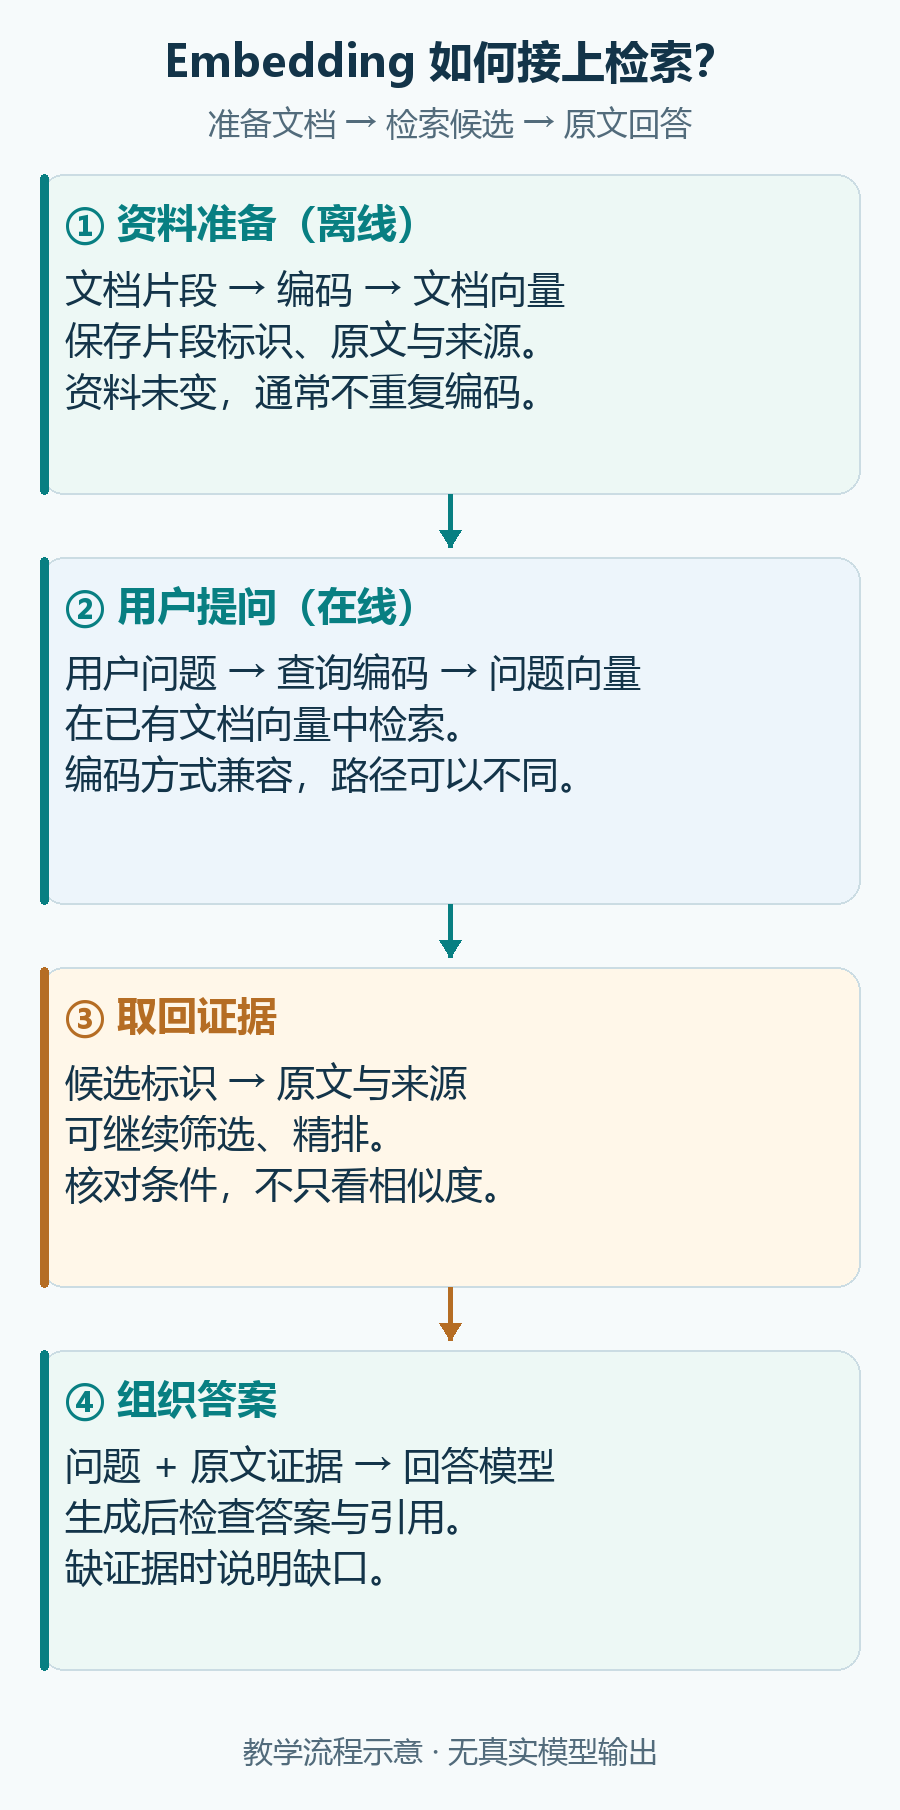
图 1:向量用于定位候选,取回的原文才是后续回答的重要依据。图中是教学流程,没有调用真实模型。
准备资料时,先解析和切块,再编码每个片段,保存向量与片段标识的对应关系。原文、标题、版本和页码等信息也要保留,存储方式可以另行设计。
用户提问时,编码当前问题,在已有文档向量中检索候选,再按片段标识取回原文。随后可以继续筛选或精排,最后把问题与证据一起交给回答模型。[2]
因此,一次新提问通常不需要把整库文档重新编码。资料修改、切块变化或嵌入配置更换时,才需要评估哪些向量应更新。
向量也不是原文的可逆压缩包。检索结束后,不能仅把几组向量数字交给普通文本回答模型,就期待它还原完整手册。
三、“相似”怎样帮助检索,又有什么限制?
可以把向量空间暂时想成一张用于匹配的地图。问题与某个片段的表示更接近,就可能更容易被检索到。但真实表示通常是高维的,画在纸上的距离只能帮助理解,不能当成实际模型结果。
常见的比较方式包括余弦相似度、点积和欧氏距离。以余弦相似度为例,它比较向量方向的一致程度;非零向量的余弦值在 -1 到 1 之间。具体采用哪种度量,要与模型及索引配置配套。[3]
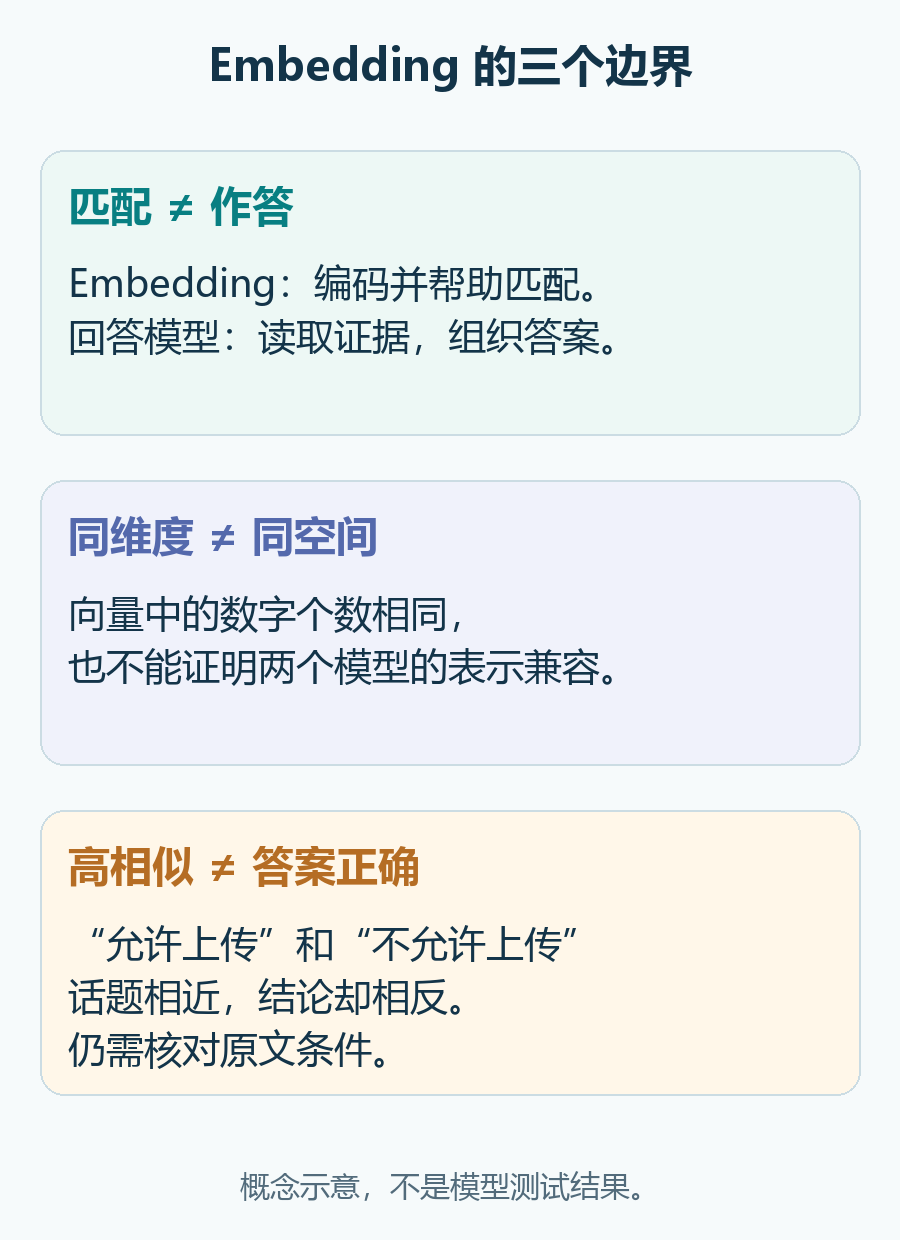
图 2:把表示、空间兼容性和证据判断分开,能避免三类常见误用。
这里有个容易误解的地方:相似度不是“回答正确的概率”。 即使某次检索得到 0.85,也不能解释成答案有 85% 的概率正确。
“允许直接上传扫描件”和“扫描件不允许直接上传”都在谈上传,表示可能接近,结论却相反。数字、否定词、适用条件和版本差异,都需要回到原文检查。
四、问题和文档必须处在兼容的表示空间
比较向量有一个前提:双方采用兼容的编码方式。
实际项目通常使用同一套嵌入模型及配套的查询、文档编码配置。某些模型要求问题和文档使用不同前缀、提示或编码路径;应按模型说明处理,不能把“兼容”理解成两边必须机械地调用完全相同的接口。[2]
维度相同,也不能证明两个模型的向量可以混用。 两套坐标都写成三个数,不代表它们使用同一套坐标规则。这个类比适用于理解兼容性,不是在描述模型的真实维度。
因此,更换嵌入模型后,通常需要重新生成文档向量、维护相应索引,并重新检查检索效果和阈值。不要只改在线问题编码器,却继续搜索旧模型生成的文档向量。
五、选模型时,先拿自己的问题比较
先检查三件事,比只看维度或某个榜单名次更有用:
- 任务是否匹配:主要是中文还是多语言?用户提的是短问题,还是在找相似长文?是否包含大量领域术语、题号或公式?
- 输入和部署是否可行:片段能否放进模型输入限制?超长时如何处理?延迟、存储、费用、许可与数据处理要求是否满足项目条件?
- 正确证据是否更容易找到:固定一组真实问题及对应证据,再比较候选中的关键片段、无关内容和响应时间。候选模型之间尽量保持切块、召回数量与过滤条件一致。
MTEB 论文也强调了跨任务评估的重要性:它的实验没有发现一种嵌入方法在所有任务上占优。这个结果不能直接替代自己的业务验证。[4]
还要分清两层效果:检索是否找到正确材料,以及最终回答是否正确。前者改善,不意味着后者一定同步改善;回答阶段可能仍会漏读条件或误用证据。
六、换一个更强的 Embedding,能解决所有问题吗?
不能。资料根本没有收录、OCR 把公式识别错了,或者切块时丢掉关键条件,嵌入模型都无法凭空补出可靠依据。
再回到“拍照扫成的 PDF 能直接传吗”:找到上传规则之后,还要读到“需先完成 OCR”这一条件,才能回答完整。若候选只包含“支持 PDF”,语义接近仍然不够。
对于精确题号、产品型号和错误码,也值得比较关键词检索的表现;候选找到了却排得靠后,可以进一步评估精排。后续文章再展开这些方法,这里先保留一个判断顺序:先定位证据在哪一步丢失,再选择要调整的组件。
七、面试时可以怎样回答?
在采用向量检索的 RAG 中,Embedding 模型把文档片段和问题编码成兼容的向量表示。文档向量通常提前生成,提问时生成问题向量,通过配套的相似度或距离检索候选,再取回原文供后续筛选和回答。模型选择应结合语言、领域、输入限制和真实问题评测;相似度不等于答案正确率,维度相同也不代表不同模型的向量可以混用。
参考资料
- Sentence Transformers:Usage——固定维度表示、检索与后续精排的职责。
- Sentence Transformers:Semantic Search——语料与查询的编码、对称与非对称检索、查询和文档编码路径。
- Sentence Transformers:Semantic Textual Similarity——相似度度量及归一化配置。
- MTEB: Massive Text Embedding Benchmark,v3(2023)——跨任务评估的研究依据,本文不引用当前排行榜结论。
- 李博杰,《深入理解 AI Agent:设计原理与工程实践》,v1.2(2026-07-22),第 3 章 §3.2.2,书内 81–83 页(PDF 89–91 页)——补充阅读。
- 题库第 311 题:RAG 中的 Embedding 向量化是什么?如何工作的?、第 254 题:如何选择 Embedding 模型?——选题参考。
评论交流
欢迎留下你的想法