给聊天机器人接入一份产品手册,它为什么就能回答手册里的问题?是不是要把文档拿去重新训练模型?
理解 RAG,可以先记住一句话:先找到相关资料,再让模型结合资料回答。 本文从一个知识库问答例子出发,拆开这条流程。
一、为什么需要 RAG?
假设我们有一份内部产品手册,里面记录了支持的文件格式和上传限制。用户问:“可以上传扫描版 PDF 吗?”
如果模型没有接入这份手册,就不能因为它认识 PDF 这个词,便认为它知道该产品的规定。把全部文档塞进每次对话,又会受到上下文长度、成本和无关内容的影响。
RAG(Retrieval-Augmented Generation,检索增强生成)提供了一种做法:提问时先从外部资料中检索相关内容,再把这些内容和问题一起交给模型。
可以把它理解为开卷答题:检索负责翻到相关材料,模型负责阅读、组织和表达答案。它的基础机制并不要求修改生成模型的参数。[1]
二、先分清两个阶段
为了看清流程,下面采用常见的“文档切块 + 向量检索”方案。RAG 也可以使用关键词检索或结构化查询,向量数据库不是所有 RAG 系统的必选项。[2]
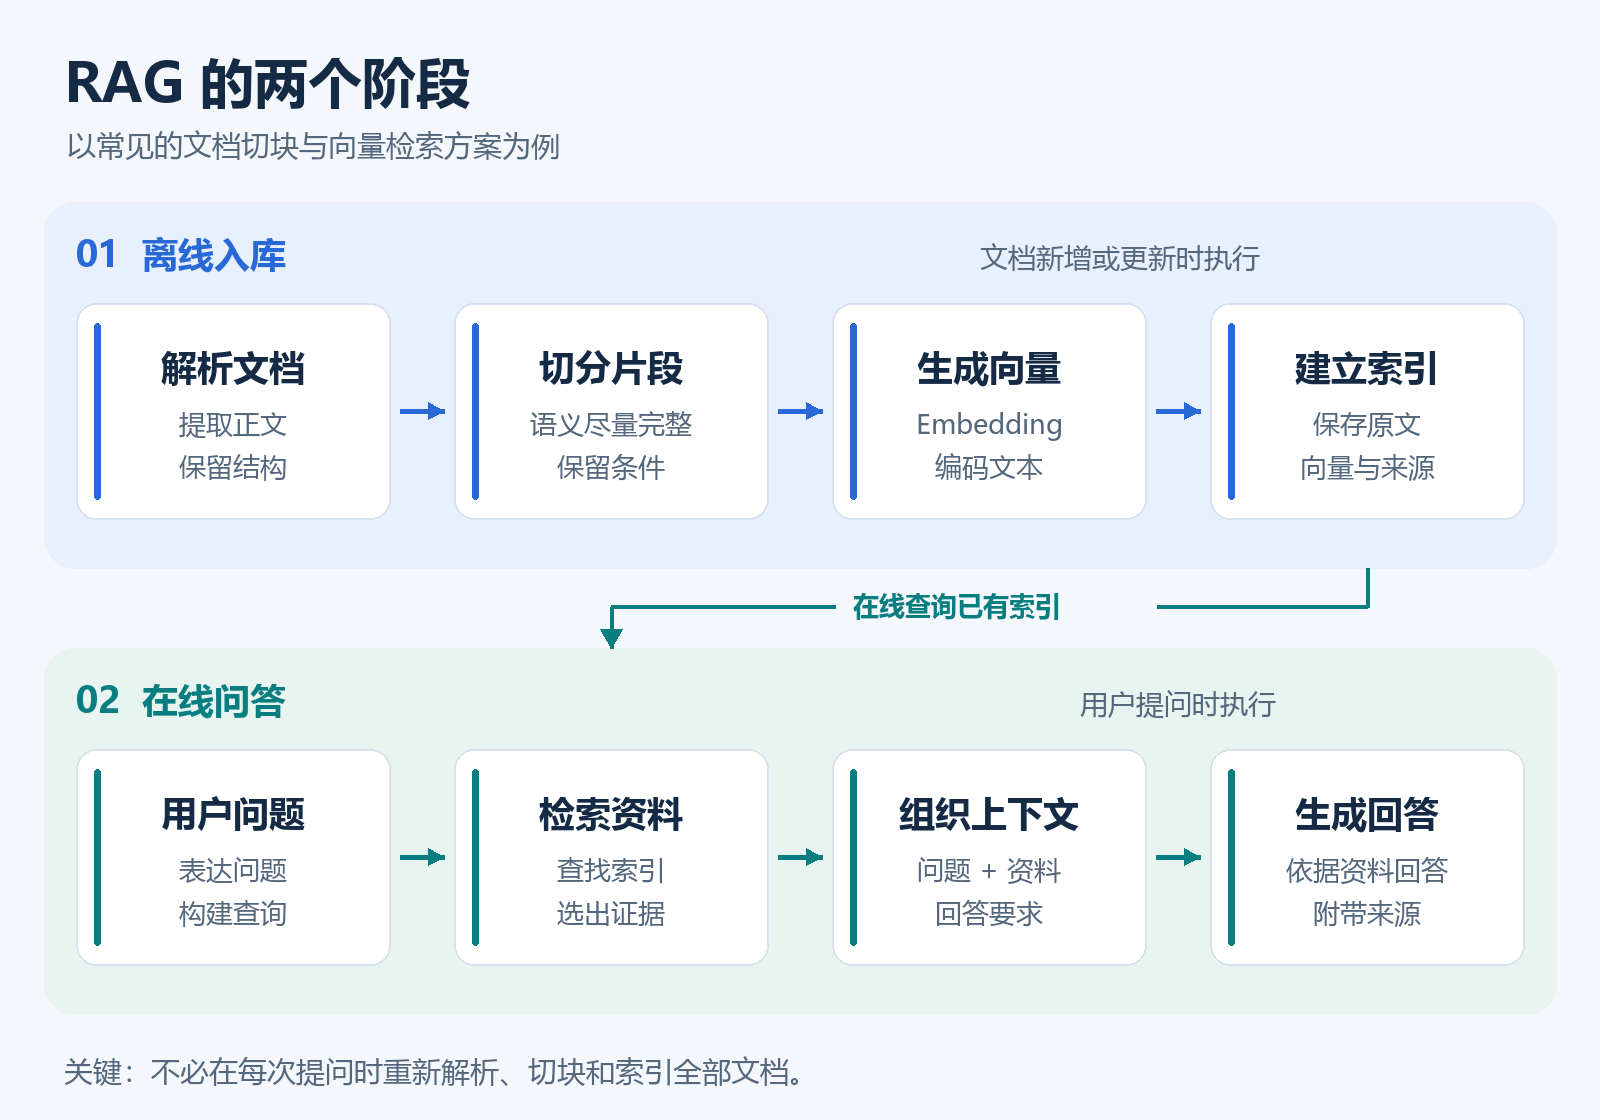
图 1:文档入库与用户提问分别执行。图中展示的是常见的向量检索实现。
1. 离线入库:把资料整理成可检索的知识库
“离线”指的是提前准备,不是断网,也不代表永远只执行一次。
- 解析文档:提取正文,保留标题、页码等信息。扫描件通常需要先做 OCR,把图片中的文字识别出来。
- 切分片段:把长文档分成适合检索的内容块。尽量保留一个完整的意思,例如不要把“支持上传”与它的限制条件拆得太远。
- 生成向量:用 Embedding 模型将文本转换为数值向量,供后续相似度检索使用。向量不是答案,也不能保证事实正确。
- 建立索引:保存向量、对应原文和来源信息,让系统能够定位材料,并在回答中提供引用。
文档更新时,需要同步更新相关内容和索引。每次提问不必重新解析全部文档。
2. 在线问答:先找证据,再生成答案
用户提问后,系统通常经历以下步骤:
- 将问题转换为检索输入。使用向量检索时,需要与文档向量采用兼容的嵌入模型和表示方式。
- 找出若干相关片段,必要时进一步筛选或重排。
- 将问题、选出的资料和回答要求一起组成模型输入。
- 让模型根据资料生成回答,并尽可能标明结论对应的来源。
检索和生成承担不同职责:检索结果只是候选材料,最终答案还需要核对证据是否充分。一个入门版本先把这条链路做好,再考虑更复杂的优化。[3]
三、用一次问答串起来
以下手册内容均为教学示例,不代表本站或某个实际产品的功能。
假设《文档助手说明书》中有两段材料:
资料 [1]:文件格式
支持上传 PDF、TXT 和 DOCX,单个文件不超过 20 MB。
资料 [2]:扫描件处理
扫描版 PDF 需要先完成 OCR,转换为可提取文字的文档后再上传。
用户问:“支持哪些文件格式?扫描版 PDF 可以直接上传吗?”
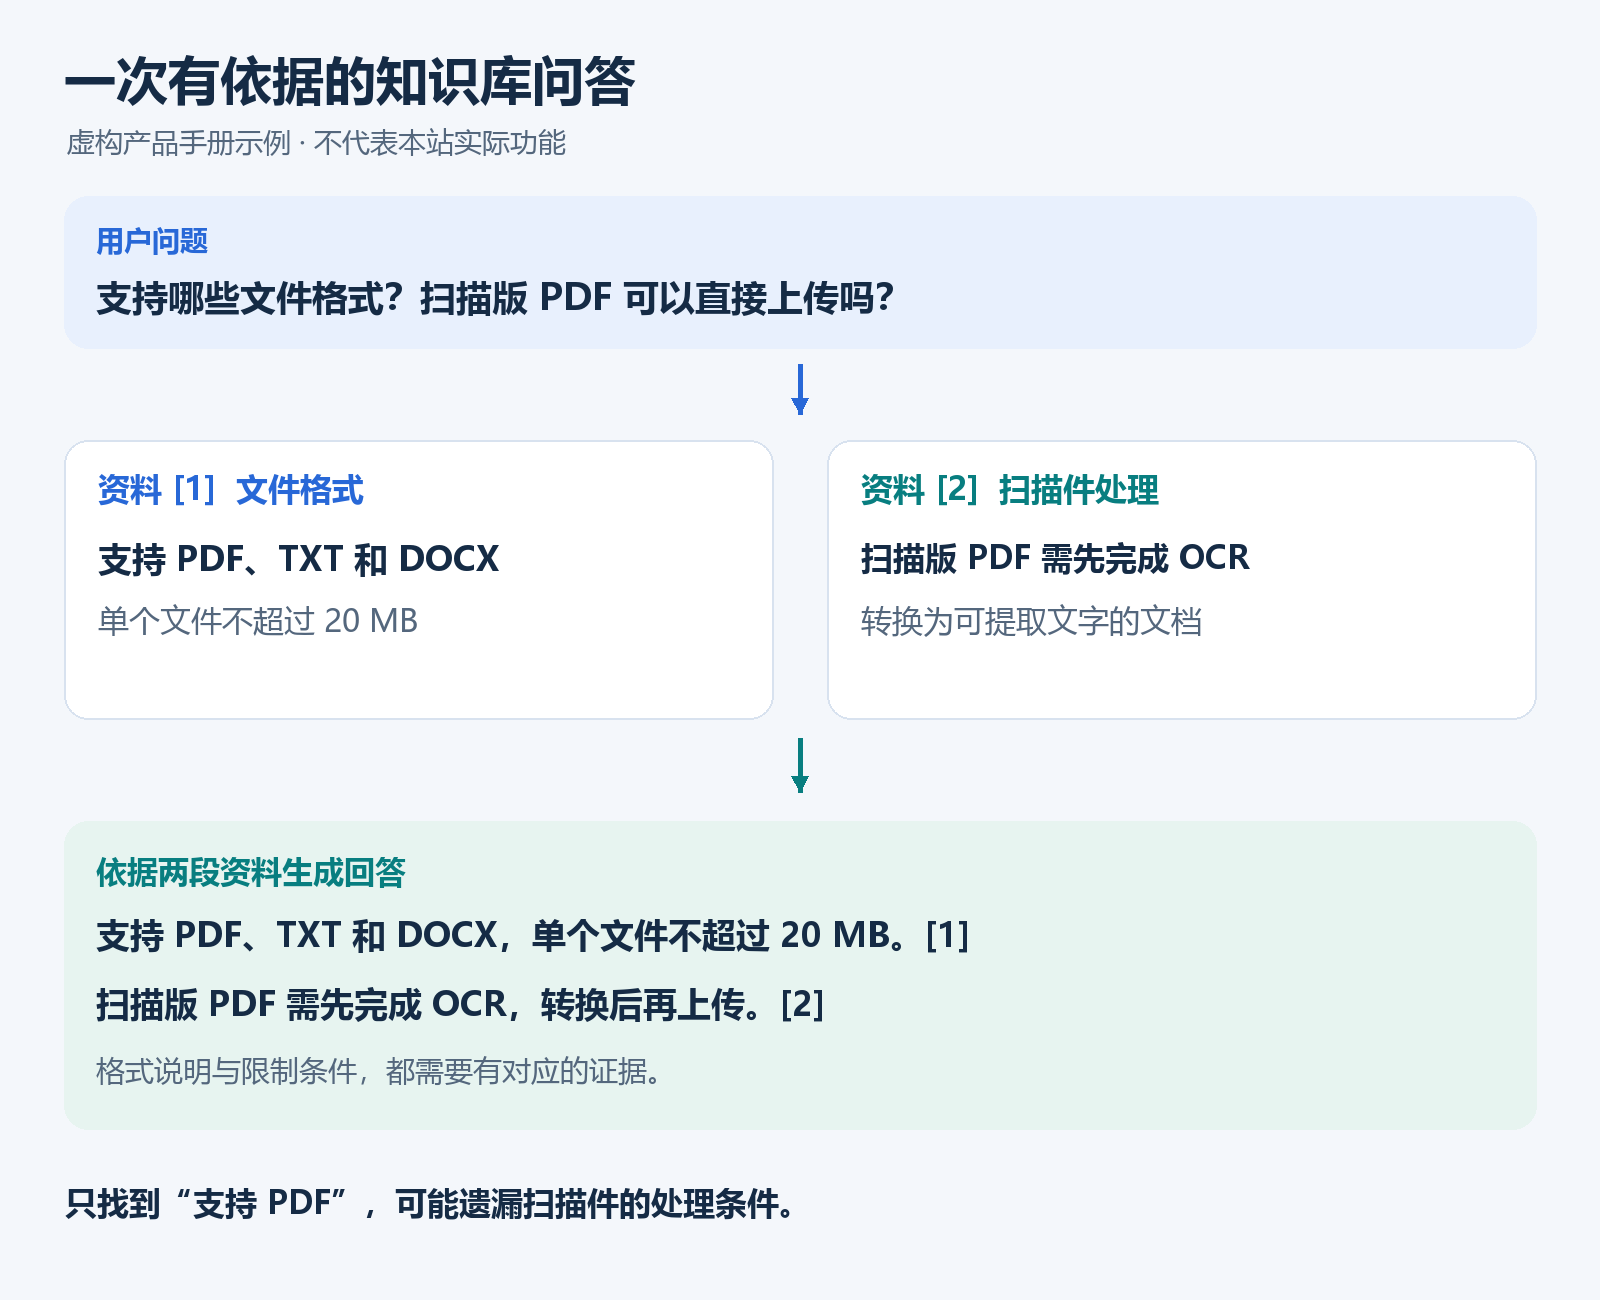
图 2:回答既要说明支持哪些格式,也要保留扫描件的处理条件。
检索器找到这两段材料后,可以把输入组织为:
请依据提供的资料回答问题,并在相关结论后标注资料编号。资料不足的部分请明确说明,不要补写产品规则。
用户问题:支持哪些文件格式?扫描版 PDF 可以直接上传吗?
参考资料:资料 [1]、资料 [2]。
期望的回答是:
支持 PDF、TXT 和 DOCX,单个文件不超过 20 MB。[1] 扫描版 PDF 不能直接上传,需要先完成 OCR,转换为可提取文字的文档。[2]
这里最容易忽略的是第二段材料。如果只检索到“支持 PDF”,就可能遗漏扫描件的限制。 这也是为什么分析 RAG 回答时,应该同时检查“找到了什么”和“如何使用这些资料”。
四、RAG 的边界在哪里?
接入知识库之后,答案仍然可能出错,常见原因有三类:
| 环节 | 可能出现的问题 | 首先检查什么 |
|---|---|---|
| 资料 | 内容过期、解析漏字、条件丢失 | 原文及解析后的片段 |
| 检索 | 找到相似话题,却没找到真正依据 | 检索片段是否覆盖问题 |
| 生成 | 忽略限制条件,或补写资料没有的结论 | 答案与引用是否逐条对应 |
另外,回答带有引用编号,不代表引用一定支持答案,仍然需要核对。
RAG 与微调也不是同一件事:RAG 的核心是在回答时提供检索得到的外部知识;微调会通过训练更新模型参数。实际系统可以组合使用两者,但“把文档接入知识库”不能直接等同于“训练了模型”。
五、面试时可以怎样回答?
RAG 是检索增强生成:先从外部知识库检索相关资料,再把资料和问题一起交给大模型生成回答。常见工程流程分为离线入库和在线问答。离线完成文档解析、切块、向量化与索引;在线完成问题检索、上下文组织和答案生成。它能让模型利用外部知识,但效果仍取决于资料、检索和生成三个环节,不能保证答案一定正确。
理解这两个阶段,就能继续追问:为什么有时检索不到完整依据?下一篇可以从分块入手,解释它是什么,以及为什么需要它。
参考资料
本文围绕题库第 2 题“什么是 RAG?RAG 的主要流程是什么?”独立整理,示例与配图为本文制作。
- Lewis 等:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks。用于理解检索与生成结合的基本思想;本文的工程流程并非逐项复现论文中的模型方案。
- LangChain 官方文档:Retrieval。包含知识库、检索组件及不同 RAG 架构的说明。
- LlamaIndex 官方文档:High-Level Concepts。参见 Retrieval Augmented Generation 一节。
- 面试鸭原题。作为选题来源,本文不复述原站完整解析。
评论交流
欢迎留下你的想法